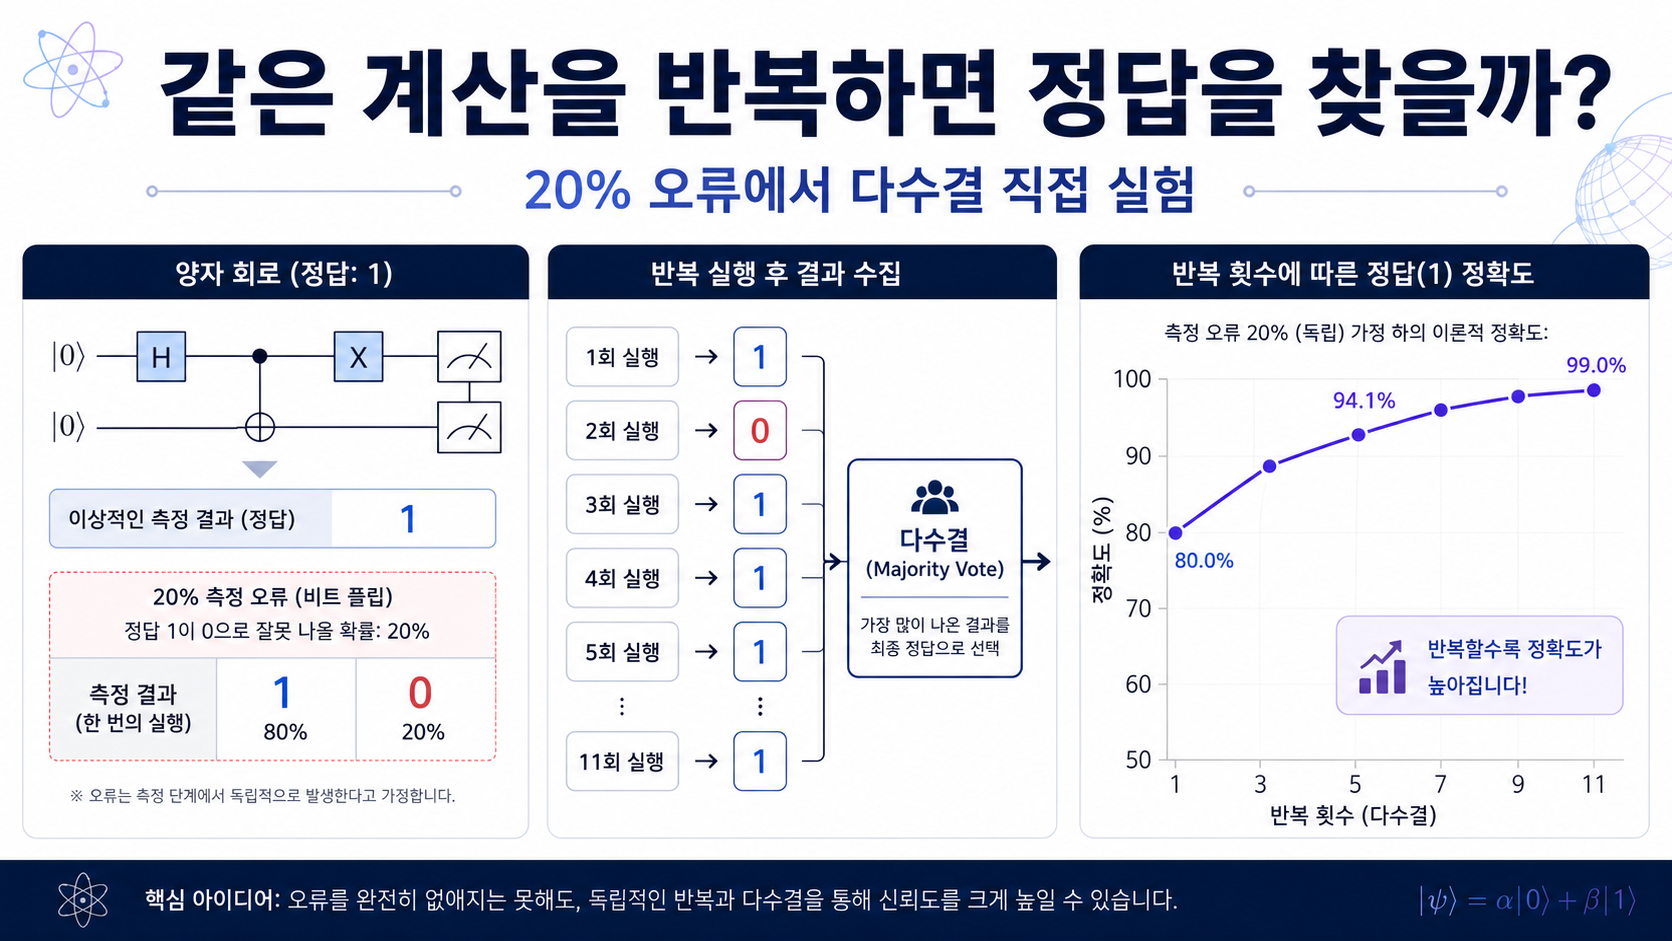
양자컴퓨터의 계산에는 오류가 섞일 수 있습니다. 저번 “초고속 시뮬레이션의 미래” 포스팅에서 오류와 반복측정에 대한 부분을 다룬 적이 있습니다. 그에 대한 실험으로 오류확률을 20%로 설정해 직접 확인했습니다. 아래 실험을 함께 확인해보시죠.
양자컴퓨터에서 한 번 계산했는데 틀린 결과가 나왔다면 같은 계산을 여러 번 반복하면 어떨까요? 오류가 무작위로 발생한다면 여러 결과 가운데 가장 많이 나온 답을 선택하는 것만으로도 정답을 찾을 가능성이 높아질 수 있습니다.
이번 실험에서는 원래 정답이 반드시 1이 되는 아주 단순한 계산을 만든 뒤, 측정할 때 20% 확률로 결과가 반대로 뒤집히는 노이즈를 적용했습니다. 이후 같은 계산을 1회, 3회, 5회, 11회, 21회, 51회 반복하고 다수결로 최종 답을 결정해 보겠습니다.
이번 실험에서 확인할 질문
- 한 번 계산할 때 오류가 있다면 정답률은 얼마나 떨어질까?
- 같은 계산을 여러 번 반복하면 정답률이 높아질까?
- 3회, 5회, 11회 반복했을 때 차이는 얼마나 날까?
- 반복횟수를 계속 늘리면 오류를 완전히 없앨 수 있을까?
- 단순 다수결과 실제 양자 오류수정은 무엇이 다를까?
실험을 아주 단순하게 만들어보자
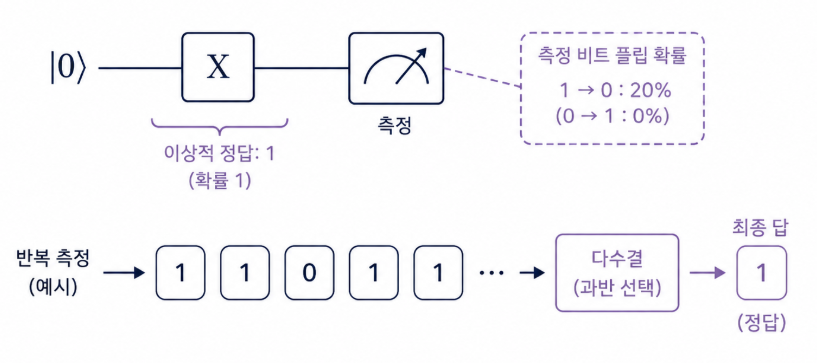
이번 실험에서는 큐비트 하나를 사용합니다. 큐비트는 처음 |0⟩ 상태에서 시작하고 X 게이트를 한 번 적용하면 |1⟩ 상태가 됩니다.
따라서 노이즈가 전혀 없다면 측정 결과는 항상 1이어야 합니다.
|0⟩ ── X ── 측정
          ↓
        정답 = 1
여기에 측정 결과가 20% 확률로 반대로 기록되는 오류를 추가합니다. 실제 특정 양자컴퓨터의 오류율을 재현하려는 것이 아니라 반복측정의 효과를 눈에 띄게 확인하기 위해 의도적으로 큰 오류를 설정한 것입니다.
실험 조건
| 항목 | 설정값 |
|---|---|
| 큐비트 | 1개 |
| 정답 | 1 |
| 정상 측정 확률 | 80% |
| 오류 확률 | 20% |
| 비교할 반복횟수 | 1, 3, 5, 11, 21, 51회 |
| 각 조건의 독립 실험 | 1,000회 |
| 최종 답 결정 | 다수결 |
| 난수 시드 | 1003 |
한 번만 실행하면 어떻게 될까?
오류가 발생하지 않을 확률을 80%로 설정했기 때문에 계산을 한 번만 수행하면 이론적으로 정답 1을 얻을 확률도 80%입니다.
반대로 말하면 같은 회로가 정확하게 만들어져 있어도 측정 한 번만 보고 답을 결정하면 약 5번 중 1번은 틀린 답을 선택할 수 있다는 뜻입니다.
3번 실행하고 다수결을 하면?
같은 계산을 세 번 실행했다고 생각해 보겠습니다.
측정 결과: 1, 0, 1

1 : 2회
0 : 1회

최종 답 → 1
한 번의 측정에서는 오류가 발생했지만 나머지 두 번이 정상이라면 다수결을 통해 원래 정답을 복구할 수 있습니다.
정상 결과가 나올 확률이 80%이고 각각의 오류가 서로 독립적이라고 가정하면 3회 다수결의 이론적인 정답확률은 약 89.6%까지 올라갑니다.
반복횟수별 정답률 직접 실험
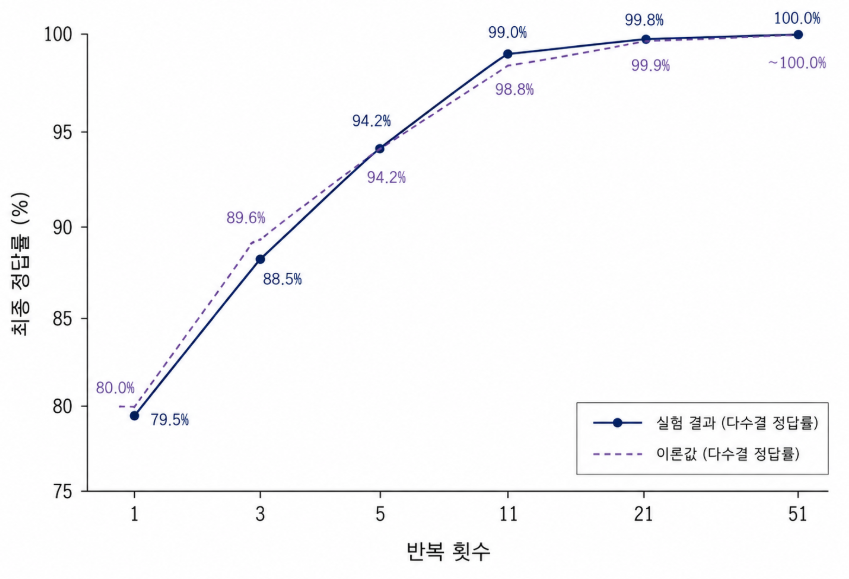
이번에는 각 반복횟수마다 같은 조건을 1,000번씩 다시 실험했습니다. 예를 들어 ‘5회 반복’ 조건은 계산을 5번 수행해 다수결로 답을 결정하는 과정을 다시 1,000번 실시한 것입니다.
import numpy as np
import math
import matplotlib.pyplot as plt

# 재현 가능한 실험
rng = np.random.default_rng(1003)

# 한 번 실행했을 때 정답이 나올 확률
p_correct = 0.8

# 홀수만 사용해야 동점이 발생하지 않음
repeat_counts = [1, 3, 5, 11, 21, 51]

# 각 조건별 독립 실험횟수
trials = 1000

measured_rates = []
theoretical_rates = []

for n in repeat_counts:

    # n번 계산했을 때 정답이 나온 횟수
    correct_counts = rng.binomial(
        n=n,
        p=p_correct,
        size=trials
    )

    # 절반보다 많이 정답이면 다수결 성공
    success = correct_counts > (n // 2)

    measured_rate = np.mean(success)

    # 다수결의 이론적인 성공확률
    theoretical_rate = sum(
        math.comb(n, k)
        * (p_correct ** k)
        * ((1 - p_correct) ** (n - k))
        for k in range(n // 2 + 1, n + 1)
    )

    measured_rates.append(measured_rate)
    theoretical_rates.append(theoretical_rate)

    print(
        f"{n:2d}회 반복 : "
        f"실험 {measured_rate * 100:.1f}% / "
        f"이론 {theoretical_rate * 100:.2f}%"
    )


plt.figure(figsize=(8, 5))

plt.plot(
    repeat_counts,
    np.array(measured_rates) * 100,
    marker="o",
    label="실험 결과"
)

plt.plot(
    repeat_counts,
    np.array(theoretical_rates) * 100,
    marker="o",
    linestyle="--",
    label="이론값"
)

plt.xlabel("같은 계산 반복횟수")
plt.ylabel("다수결 정답률 (%)")
plt.title("반복 계산에 따른 최종 정답률")
plt.ylim(70, 101)
plt.grid(True)
plt.legend()
plt.show()
실제 실행 결과
| 계산 반복횟수 | 이론 정답률 | 실제 실행 결과 | 1,000번 중 성공 |
|---|---|---|---|
| 1회 | 80.0% | 79.5% | 795회 |
| 3회 | 89.6% | 88.5% | 885회 |
| 5회 | 94.2% | 94.2% | 942회 |
| 11회 | 98.8% | 99.0% | 990회 |
| 21회 | 99.9% | 99.8% | 998회 |
| 51회 | 약 100.0% | 100.0% | 1,000회 |
한 번만 계산했을 때는 1,000번의 독립 실험 중 795번 정답을 얻어 79.5%의 성공률을 기록했습니다.
같은 계산을 세 번 수행한 뒤 다수결로 답을 결정하자 정답률은 88.5%로 증가했고, 5회에서는 94.2%, 11회에서는 99.0%까지 올라갔습니다.
21회 반복에서는 1,000개의 실험 가운데 998개가 정답이었고, 51회 반복 조건에서는 이번 1,000번의 실험에서 잘못된 최종 답이 한 번도 나오지 않았습니다.
다만 51회 반복의 결과가 100.0%였다고 해서 오류 가능성이 수학적으로 완전히 0이 된 것은 아닙니다. 이번에 수행한 1,000개의 실험에서 우연히 실패가 관측되지 않았다는 의미입니다.
왜 반복하면 정답률이 높아질까?
핵심은 한 번의 계산에서 정답이 나올 확률이 50%보다 높다는 점입니다.
이번 조건에서는 각각의 측정이 80%의 확률로 정답을 냅니다. 여러 번 독립적으로 반복하면 오류가 일부 포함되더라도 정상적인 결과가 더 많이 쌓일 가능성이 높습니다.
따라서 홀수 번 반복하고 가장 많이 나온 값을 선택하면 개별 오류의 영향을 줄일 수 있습니다.
그렇다면 계속 반복하기만 하면 되는 걸까?
여기에는 중요한 조건이 있습니다. 이번 실험에서는 오류가 각각 독립적으로 발생하고, 한 번 계산했을 때 정답확률이 80%라는 단순한 조건을 사용했습니다.
- 오류가 서로 독립적이어야 합니다.
- 한 번 실행했을 때 정답이 나올 확률이 50%보다 높아야 합니다.
- 정답을 다수결로 결정할 수 있는 문제여야 합니다.
- 특정 방향으로 계속 치우치는 시스템 오류가 크지 않아야 합니다.
예를 들어 하드웨어가 특정 결과를 계속 잘못 측정하는 체계적인 오류를 갖고 있다면 같은 계산을 수천 번 반복해도 잘못된 값만 더 정밀하게 측정할 수 있습니다.
반복측정과 양자 오류수정은 다르다
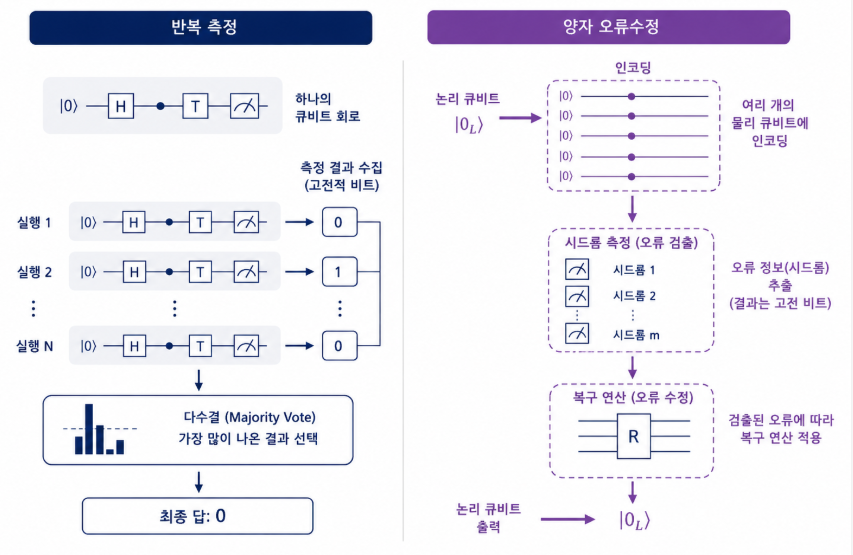
이번 실험에서 사용한 방법은 결과를 여러 번 얻은 뒤 고전적으로 다수결을 하는 방식입니다. 이것만으로 실제 양자 오류수정이 이루어진 것은 아닙니다.
양자 오류수정에서는 하나의 논리적 양자정보를 여러 물리적 큐비트에 분산해 저장하고, 양자상태 자체를 직접 측정해 파괴하지 않으면서 오류 정보를 확인하기 위해 안정자(stabilizer) 측정 등을 사용합니다.
단순한 repetition code에서도 여러 비트 또는 큐비트를 사용하고 다수결 원리를 이용할 수 있지만 실제 범용 양자 오류수정은 비트플립뿐 아니라 위상오류까지 함께 다뤄야 합니다.
실제 양자알고리즘에서는 왜 더 복잡할까?
모든 양자알고리즘의 결과가 하나의 정답 비트로 나오는 것은 아닙니다. 중첩을 사용하는 회로는 정상적인 상태에서도 여러 결과가 일정한 확률분포로 나타날 수 있습니다.
이런 경우에는 가장 많이 나온 결과 하나만 선택하기보다 여러 번의 측정으로 확률분포나 관측량의 기대값을 추정합니다. 측정횟수를 늘리면 표본에 의한 통계적 불확실성은 줄어들지만 하드웨어 자체의 편향이나 게이트 오류가 자동으로 제거되는 것은 아닙니다.
현재 양자컴퓨팅에서는 이러한 문제를 줄이기 위해 측정 오류완화, zero-noise extrapolation, 오류 억제, 양자 오류수정 등 다양한 방법이 연구되고 있습니다.
이번 실험에서 확인한 핵심
- 오류확률이 20%라면 한 번의 계산만으로는 약 80%의 확률로 정답을 얻습니다.
- 독립적인 확률 오류에서는 같은 계산을 반복하고 다수결을 하면 정답률이 높아질 수 있습니다.
- 실험에서는 1회 79.5%에서 11회 99.0%까지 정답률이 증가했습니다.
- 반복횟수가 늘어날수록 계산비용과 측정횟수도 함께 증가합니다.
- 반복측정만으로 모든 종류의 양자오류를 제거할 수는 없습니다.
- 시스템적인 편향과 상관된 오류에는 단순 다수결이 충분하지 않을 수 있습니다.
- 실제 양자컴퓨터에서는 오류완화와 양자 오류수정 기술이 별도로 필요합니다.
같이 읽어볼 글
참고문헌
- IBM Quantum Documentation – Repetition codes
- IBM Quantum Learning – Classical repetition codes and majority decoding
- IBM Quantum Documentation – Overview of noise management techniques
- IBM Quantum Documentation – Readout error mitigation for the Sampler primitive
- Qiskit Aer Documentation – Building Noise Models
이번 결과는 특정 IBM QPU의 실제 오류율을 측정한 것이 아니라, 한 번의 결과가 20% 확률로 뒤집힌다는 독립 오류 모델을 설정하고 동일한 계산을 반복했을 때 다수결의 효과를 확인한 확률 시뮬레이션입니다.