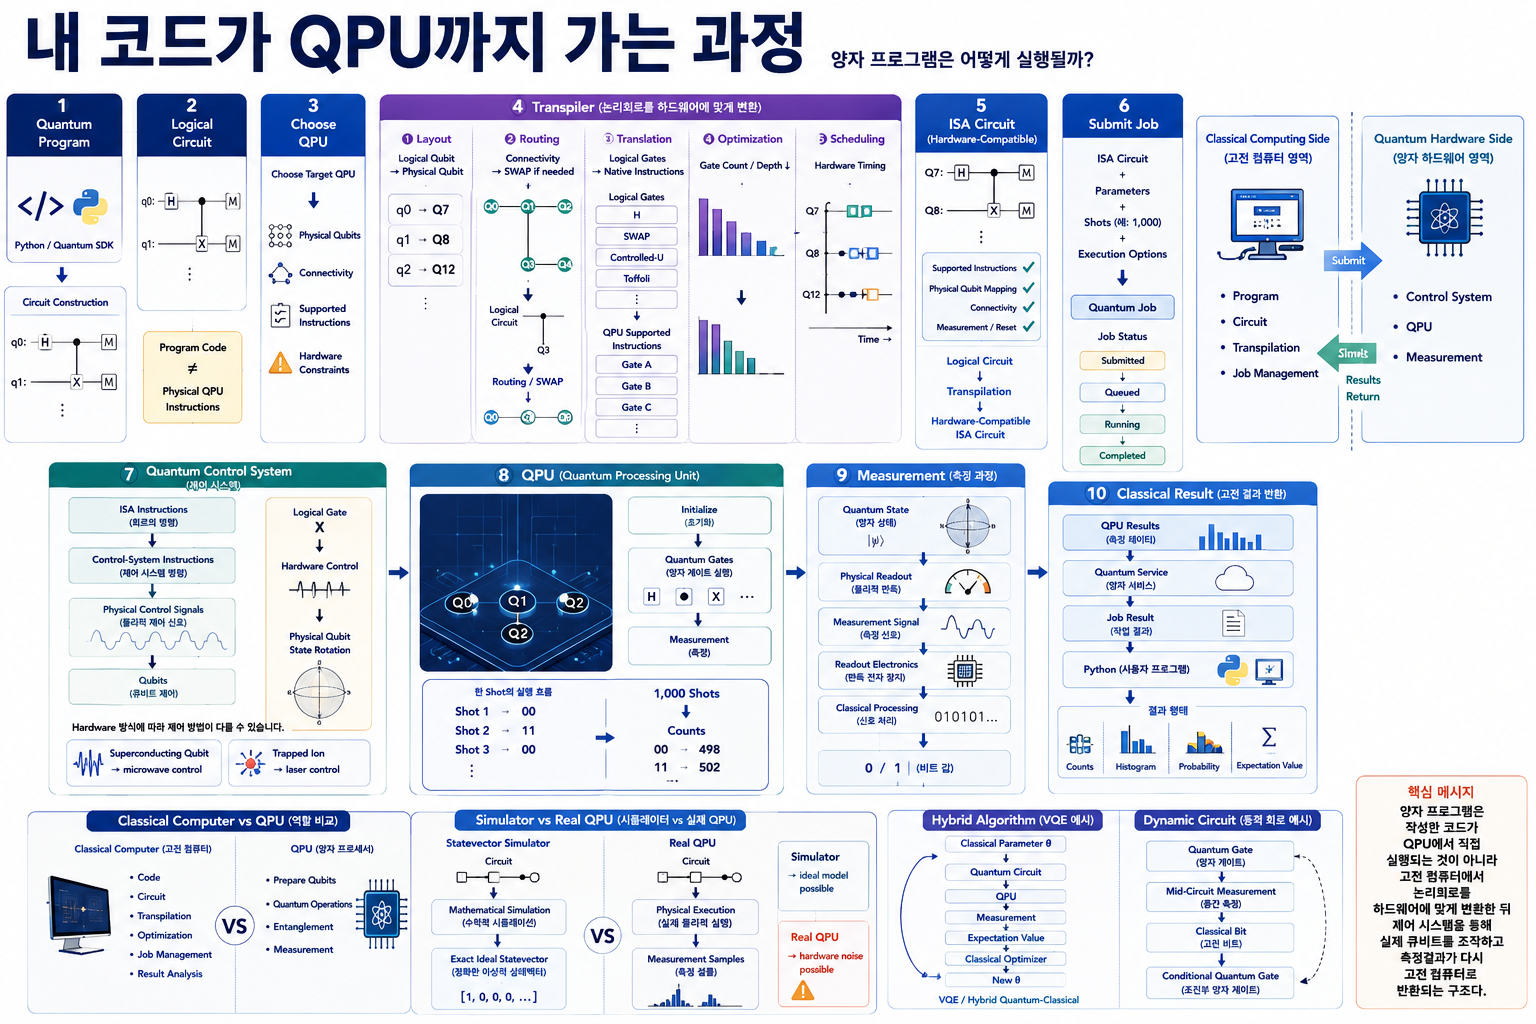
양자컴퓨팅에서 내가 만든 양자회로는 실제로 어떻게 실행될까요? 양자 프로그램은 논리 회로를 실제 장치의 큐비트 연결과 지원 연산에 맞게 바꾼 뒤 제어 시스템을 거쳐 실행되는데요. 복잡하지만 아래 글을 통해 쉽게 정리할 수 있을겁니다. 함께보시죠.

양자 프로그램을 실행하면 실제로 어떤 일이 일어날까?
양자컴퓨팅을 처음 공부하면 Python으로 양자회로를 작성한 뒤 실행 버튼을 누르면 코드가 그대로 양자컴퓨터 내부로 전달되는 것처럼 생각하기 쉬운데요.
실제 과정은 훨씬 여러 단계로 이루어집니다. 사용자가 작성한 프로그램은 먼저 양자회로라는 추상적인 계산 구조로 표현되고, 실행할 QPU의 특성에 맞게 다시 변환됩니다. 그 뒤 클라우드 서비스나 실행 시스템을 통해 작업이 제출되고, 최종적으로 실제 물리적 큐비트를 제어하는 명령으로 바뀌어 실행됩니다.
Quantum Program

↓

Logical Quantum Circuit

↓

Choose QPU

↓

Transpilation

↓

ISA / Hardware-Compatible Circuit

↓

Job Submission

↓

Control System

↓

Physical Qubit Operations

↓

Measurement

↓

Classical Results
따라서 우리가 화면에서 보는 H, X, CNOT 같은 게이트는 알고리즘을 표현하기 위한 논리적인 명령이고, 실제 하드웨어에서는 이를 해당 장치가 실행할 수 있는 형태로 변환하는 과정이 필요합니다.
첫 번째 단계는 고전 컴퓨터에서 양자 프로그램을 작성하는 것이다
양자컴퓨터를 사용한다고 해서 모든 프로그램이 처음부터 양자 하드웨어 안에서 동작하는 것은 아닙니다.
일반적으로 개발자는 노트북이나 서버 같은 고전 컴퓨터에서 Python과 양자 SDK를 이용해 프로그램을 작성합니다.
Classical Computer

Python

↓

Quantum SDK

↓

Quantum Circuit
예를 들어 한 큐비트에 Hadamard 게이트를 적용하고 측정하는 프로그램을 작성할 수 있습니다.
|0⟩

↓

H

↓

Measurement
이 단계에서 작성된 것은 아직 특정 양자칩의 물리적 동작 자체가 아니라 어떤 양자연산을 수행하고 싶은지를 표현한 논리적인 회로에 가깝습니다.
논리 양자회로란 무엇일까?
논리 양자회로는 알고리즘 관점에서 필요한 큐비트와 게이트의 관계를 표현한 회로입니다.
Logical Circuit

q0: ─H────●────M
          │
q1: ──────X────M
여기에서 q0와 q1은 실제 칩의 특정 물리 큐비트를 의미한다고 볼 필요가 없습니다. 우선 알고리즘에서 사용하는 가상의 큐비트라고 이해하면 쉽습니다.
또 H나 CNOT 역시 사용자가 계산을 이해하기 편하도록 표현한 논리적 연산입니다. 실제 양자프로세서가 반드시 H나 CNOT이라는 이름의 물리적 동작을 그대로 지원하는 것은 아닙니다.
| 구분 | 의미 |
|---|---|
| 프로그램 코드 | 개발자가 작성한 고수준 명령 |
| 논리 큐비트 | 알고리즘에서 사용하는 추상적인 큐비트 |
| 논리 게이트 | X·H·CNOT 등 알고리즘 수준의 양자연산 |
| 논리 회로 | 양자 알고리즘의 연산순서를 표현한 구조 |
| 물리 QPU | 실제로 큐비트와 제어장치가 존재하는 양자 하드웨어 |
두 번째 단계는 어떤 양자 하드웨어에서 실행할지 정하는 것이다.
논리회로를 만들었다면 다음으로 실제 계산을 수행할 대상 QPU를 선택합니다.
이 과정이 중요한 이유는 양자프로세서마다 조건이 서로 다를 수 있기 때문입니다.
- 사용 가능한 물리 큐비트 수
- 큐비트끼리 직접 연결된 구조
- 지원되는 기본 게이트
- 게이트와 측정의 특성
- 동적 회로 지원 여부
- 실행 대기 상태
따라서 동일한 논리회로라도 어떤 QPU를 대상으로 하느냐에 따라 실제 실행되는 회로는 달라질 수 있습니다.
Same Logical Circuit

        ↓

QPU A
→ Physical Circuit A


QPU B
→ Physical Circuit B
왜 논리회로를 QPU에 그대로 보낼 수 없을까?
가장 큰 이유는 실제 하드웨어에 제약이 있기 때문입니다.
예를 들어 논리회로에서는 q0와 q4 사이에 바로 CNOT을 사용할 수 있습니다.
Logical Circuit

q0 ─────●────
        │
q4 ─────X────
하지만 실제 QPU가 다음처럼 연결되어 있다고 생각해 보겠습니다.
Physical QPU

Q0 ─ Q1 ─ Q2 ─ Q3 ─ Q4
Q0와 Q4가 직접 상호작용할 수 없다면 논리회로의 CNOT을 그대로 실행할 수 없습니다.
또 논리회로에 사용된 특정 게이트가 대상 하드웨어의 기본 명령집합에 없다면 해당 게이트를 지원되는 다른 게이트의 조합으로 바꿔야 합니다.
세 번째 단계는 Transpilation이다
이런 문제를 해결하는 대표적인 과정이 Transpilation입니다.
Transpiler는 사용자가 작성한 논리적인 양자회로를 분석해 선택한 QPU에서 실행할 수 있는 형태로 바꿉니다.
Logical Circuit

↓

Transpiler

↓

Hardware-Compatible Circuit
Qiskit의 일반적인 Transpilation 과정은 초기 변환, Layout, Routing, Translation, Optimization, Scheduling 같은 단계로 나눠 이해할 수 있습니다.
| 단계 | 주요 역할 |
|---|---|
| Init | 복잡한 명령을 기본적인 회로 구조로 정리 |
| Layout | 논리 큐비트를 물리 큐비트에 배치 |
| Routing | 하드웨어 연결성에 맞게 필요한 이동 연산 추가 |
| Translation | 게이트를 QPU가 지원하는 기본 명령으로 변환 |
| Optimization | 불필요한 게이트와 회로 깊이를 줄임 |
| Scheduling | 필요하면 실제 시간축의 실행순서를 고려 |
Layout에서는 논리 큐비트를 실제 큐비트에 배치한다
논리회로의 q0, q1, q2를 실제 QPU의 어떤 큐비트에서 실행할지 결정하는 과정이 Layout입니다.
Logical

q0
q1
q2

↓

Layout

↓

Physical

Q7
Q8
Q12
아무 물리 큐비트에 무작위로 배치하면 되는 것은 아닙니다. 서로 자주 상호작용하는 논리 큐비트를 실제 장치에서도 가까운 위치에 배치하면 이후 필요한 Routing 연산을 줄일 수 있습니다.
또 실제 하드웨어 특성을 고려하는 최적화에서는 물리 큐비트와 연결의 품질도 배치 결정에 영향을 줄 수 있습니다.
Routing에서는 연결되지 않은 큐비트 문제를 해결한다
논리회로에서는 연결 여부를 크게 신경 쓰지 않고 여러 큐비트 사이에 게이트를 사용할 수 있지만 물리 QPU는 그렇지 않습니다.
필요한 두 물리 큐비트가 직접 상호작용할 수 없다면 양자상태의 위치를 옮기는 SWAP과 같은 연산이 추가될 수 있습니다.
Need:

Q0 ↔ Q3 interaction


Hardware:

Q0 ─ Q1 ─ Q2 ─ Q3


Routing

↓

SWAP / Mapping Changes

↓

Required qubits become compatible
문제는 이런 추가 연산 역시 실제 QPU에서 실행해야 한다는 것입니다. 따라서 좋은 Transpilation은 가능한 한 불필요한 Routing 비용을 줄이려고 합니다.
Translation에서는 게이트를 QPU의 명령어로 바꾼다
사용자가 논리회로에서 사용할 수 있는 양자 게이트의 종류는 매우 많습니다.
반면 실제 QPU가 기본적으로 지원하는 명령집합은 제한되어 있습니다.
Logical Gates

H
X
SWAP
Toffoli
Arbitrary U

↓

Translation

↓

QPU-Supported Instructions

Gate A
Gate B
Gate C
...
따라서 논리 게이트를 실제 장치가 지원하는 Basis Gate 또는 Native Instruction의 조합으로 분해하는 과정이 필요합니다.
예를 들어 논리회로에서는 SWAP 하나로 보였던 연산이 특정 명령집합에서는 여러 개의 2큐비트 게이트로 분해될 수 있습니다.
ISA Circuit은 무엇일까?
실제 QPU에 제출할 수 있도록 장치의 명령집합과 연결성 제약을 모두 만족하는 회로를 ISA Circuit이라는 표현으로 접할 수 있습니다.
ISA는 Instruction Set Architecture의 약자로, 해당 하드웨어에서 어떤 명령을 어떤 큐비트와 연결관계에서 사용할 수 있는지를 규정하는 일종의 실행 규칙이라고 이해하면 쉽습니다.
Logical Circuit

↓

Transpilation

↓

ISA Circuit

Conditions:

Supported Instructions ✓
Physical Qubit Mapping ✓
Connectivity ✓
Measurement / Reset Rules ✓
IBM Quantum에서는 실제 Backend에 제출하는 회로가 대상 시스템의 ISA를 만족해야 합니다.
회로 최적화는 이 과정에서 왜 함께 이루어질까?
Layout과 Routing, Translation을 수행하면 원래 논리회로보다 실제 실행 회로가 더 길어질 수 있습니다.
Logical Circuit

10 Gates

↓

Routing + Translation

↓

Physical Circuit

30 Gates

↓

Optimization

↓

22 Gates
위 숫자는 이해를 위한 예시지만 실제로 하드웨어 제약을 반영하는 과정에서 추가 연산이 생길 수 있다는 점이 중요합니다.
그래서 Transpiler는 서로 상쇄되는 게이트를 제거하거나 연속된 회전을 합치고, 더 효율적인 게이트 조합을 찾아 회로의 Gate Count와 Circuit Depth를 줄이려고 합니다.
여기까지는 아직 고전 컴퓨터가 처리하는 과정이다
중요한 점이 하나 있습니다.
Python 코드 작성부터 회로 생성, Transpilation, Layout과 Routing 계산까지 상당 부분은 고전 컴퓨터에서 이루어집니다.
Classical Computer

Program
↓
Circuit Construction
↓
Transpilation
↓
Optimization
↓
ISA Circuit

        │
        │ submit
        ▼

Quantum System

QPU Execution
양자컴퓨터가 모든 일을 대신 처리하는 것이 아니라 고전 컴퓨터가 회로를 준비하고 실행계획을 만든 뒤 실제 양자연산이 필요한 부분을 QPU에 맡기는 구조입니다.
네 번째 단계는 실행할 회로와 조건을 제출하는 것이다
하드웨어에서 실행할 수 있는 회로가 준비되면 실제 양자컴퓨팅 서비스에 실행작업을 제출합니다.
이때 회로뿐 아니라 다음과 같은 실행정보가 함께 사용될 수 있습니다.
- 실행 대상 QPU
- 측정 반복 횟수인 Shots
- 양자회로
- 회로의 파라미터 값
- 실행 옵션
- 오류 억제 또는 완화 설정
ISA Circuit

+

Parameters

+

Shots

+

Execution Options

↓

Submit Job
사용자 입장에서는 실행 명령 한 줄처럼 보일 수 있지만 이때부터 실제 원격 양자시스템의 작업 관리 절차로 넘어가게 됩니다.
Job이라는 개념은 무엇일까?
클라우드 양자컴퓨팅에서는 사용자가 제출한 실행요청을 Job이라는 작업 단위로 접하는 경우가 많습니다.
User

↓

Submit

↓

Quantum Job

↓

Queued

↓

Running

↓

Completed

↓

Result
작업을 제출했다고 곧바로 QPU가 실행되는 것은 아닐 수 있습니다. 다른 사용자의 작업이나 시스템 운영상황에 따라 대기과정을 거칠 수도 있습니다.
Azure Quantum에서도 프로그램을 대상 하드웨어에 맞는 형식으로 컴파일한 뒤 Target에 Job을 제출하고 상태를 확인한 후 결과를 가져오는 구조를 사용합니다.
Shots는 이 실행과정에서 어디에 들어갈까?
양자회로를 한 번 측정하면 하나의 측정 샘플을 얻습니다. 확률분포나 기대값을 추정하려면 동일한 회로를 여러 번 실행해야 합니다.
Circuit

↓

Shot 1
→ 00

Shot 2
→ 11

Shot 3
→ 00

Shot 4
→ 00

...

↓

Counts / Probability
따라서 Job 내부에서 하나 이상의 회로가 여러 Shot으로 실행될 수 있습니다.
Shot은 회로의 게이트 수나 깊이가 아니라 동일한 회로에서 몇 개의 측정 샘플을 얻을지를 나타내는 실행조건입니다.
다섯 번째 단계부터 실제 QPU와 제어 시스템이 중요해진다
ISA 회로가 실제 양자시스템에 전달되었다고 해서 Python 명령이나 회로 그림이 그대로 큐비트에 들어가는 것은 아닙니다.
QPU에는 물리적인 큐비트와 이를 정밀하게 제어하는 전자장치 또는 광학·레이저 제어 시스템 등이 존재합니다. 구체적인 구현은 초전도체, 이온트랩, 중성원자 등 어떤 방식의 양자 하드웨어인지에 따라 달라집니다.
ISA Circuit

↓

Quantum Control Stack

↓

Low-Level Control Instructions

↓

Physical Control Signals

↓

Qubits
즉 회로의 추상적인 게이트가 실제 하드웨어에서는 물리계의 양자상태를 원하는 방향으로 변화시키는 제어동작으로 구현됩니다.
양자 게이트는 실제 하드웨어에서 무엇일까?
회로에서 X 게이트를 그리면 작은 사각형 안에 X 하나만 보입니다.
Logical View

|0⟩
──X──
|1⟩
하지만 실제 QPU에서 X라고 적힌 작은 물리적 상자가 큐비트에 붙는 것은 아닙니다.
하드웨어 제어 시스템이 대상 물리 큐비트에 맞는 제어신호를 발생시켜 큐비트 상태가 원하는 X 연산과 동일한 변환을 하도록 만듭니다.
Logical X Gate

↓

Hardware Control Instruction

↓

Physical Interaction

↓

Equivalent Quantum State Rotation
따라서 양자회로의 게이트는 실제 물리장치의 작동을 추상화한 명령이라고 이해하는 것이 좋습니다.
초전도 큐비트에서는 어떻게 제어할까?
초전도 큐비트를 예로 들면 정밀하게 조절된 전자기 신호를 이용해 양자상태를 변화시킬 수 있습니다.
Control Electronics

↓

Microwave Control

↓

Superconducting Qubit

↓

Quantum State Rotation
회전각과 위상, 신호의 시간적 특성을 조절해 특정 단일 큐비트 연산을 구현할 수 있고 두 큐비트 사이의 상호작용을 제어해 다중 큐비트 게이트를 구현합니다.
다른 방식의 양자컴퓨터에서는 레이저나 다른 종류의 물리적 상호작용을 사용할 수 있으므로 모든 QPU가 동일한 방식으로 게이트를 구현한다고 생각해서는 안 됩니다.
논리 게이트와 물리적 제어 명령 사이에는 여러 계층이 존재한다
양자 프로그램의 실행과정을 이해할 때 가장 중요한 부분 가운데 하나가 추상화 계층입니다.
Algorithm

↓

Programming Language / SDK

↓

Quantum Circuit

↓

ISA Instructions

↓

Control-System Instructions

↓

Physical Signals

↓

Quantum Device
개발자는 모든 물리적 제어신호를 직접 설계하지 않아도 높은 수준의 양자게이트로 프로그램할 수 있습니다.
반대로 하드웨어 개발자는 아래쪽 제어계층에서 게이트의 정확도와 타이밍을 개선하면서 위쪽에서는 동일한 회로 인터페이스를 제공할 수 있습니다.
QPU에서 하나의 Shot이 실행되는 과정을 보자
실제 실행을 단순화하면 한 Shot은 다음과 같은 흐름으로 이해할 수 있습니다.
Prepare Qubits

↓

Initial State

↓

Apply Physical Gate Operations

↓

Quantum State Evolves

↓

Measurement

↓

Classical Bitstring
예를 들어 두 큐비트 회로를 측정하면 하나의 Shot에서 00, 01, 10, 11 가운데 하나의 비트열을 얻을 수 있습니다.
같은 회로를 1,000 Shots로 실행한다면 이 준비·연산·측정 과정에 대응하는 표본이 반복적으로 만들어집니다.
여섯 번째 단계는 양자상태를 측정하는 것이다
양자프로세서에서 계산이 끝났다고 해서 내부 양자상태 전체가 그대로 사용자 화면에 전송되는 것은 아닙니다.
실제 QPU에서는 측정 과정을 통해 필요한 양자정보를 고전적인 결과로 변환합니다.
Quantum State

|ψ⟩

↓

Measurement

↓

Classical Result

0 / 1

or

Bitstring
한 큐비트를 측정하면 일반적으로 0 또는 1과 연결된 고전적 결과를 얻고 여러 큐비트를 측정하면 00101과 같은 비트열을 얻을 수 있습니다.
측정 신호는 어떻게 0과 1로 바뀔까?
물리적 측정장치는 처음부터 Python 정수 0이나 1을 만들어내는 장치라고 생각하면 지나치게 단순합니다.
하드웨어에서는 큐비트 상태에 따라 달라지는 물리적 측정신호가 발생하고 제어·판독 시스템이 이 신호를 처리해 최종적인 고전 측정값으로 분류합니다.
Physical Qubit

↓

Readout Interaction

↓

Analog / Physical Signal

↓

Readout Electronics

↓

Signal Processing

↓

Classical 0 or 1
이 과정에도 완벽하지 않은 부분이 존재할 수 있기 때문에 실제 양자컴퓨팅에서는 Measurement Error라는 개념도 중요합니다.
여러 Shots가 끝나면 측정결과가 집계된다
예를 들어 Bell 상태를 1,000번 측정했다고 생각해 보겠습니다.
Shot 1 → 00
Shot 2 → 11
Shot 3 → 00
Shot 4 → 11
Shot 5 → 11
...

↓

Counts

00 → 498
11 → 502
Counts를 전체 Shot 수로 나누면 측정 확률을 추정할 수 있습니다.
P̂(00)

=

498 / 1000

=

49.8%


P̂(11)

=

502 / 1000

=

50.2%
이렇게 만들어진 고전 데이터가 다시 사용자의 프로그램으로 반환됩니다.
일곱 번째 단계는 결과가 다시 고전 컴퓨터로 돌아오는 것이다
QPU가 측정을 마치면 결과는 서비스의 실행 시스템을 거쳐 사용자가 실행한 프로그램으로 반환됩니다.
QPU

↓

Measurement Results

↓

Quantum Service

↓

Job Result

↓

Python Program

↓

Counts / Histogram / Expectation Value
개발자는 결과를 Counts나 확률분포로 확인하거나 기대값을 계산하고, 다시 새로운 회로 또는 파라미터를 만들 수 있습니다.
양자컴퓨터와 고전컴퓨터가 함께 동작하는 이유
지금까지의 과정을 보면 실제 양자 프로그램은 고전 컴퓨터와 QPU의 협업으로 이루어진다는 사실을 알 수 있습니다.
| 고전 컴퓨터 | 양자 프로세서 |
|---|---|
| 프로그램 실행 | 양자상태 준비 |
| 회로 생성 | 양자 게이트 실행 |
| Transpilation | 다중 큐비트 상호작용 |
| 파라미터 계산 | 양자상태 변화 |
| Job 관리 | 측정 |
| 측정 결과 분석 | 고전 결과 생성에 필요한 물리적 판독 |
양자컴퓨터는 기존 컴퓨터 전체를 통째로 대체하기보다 특정 양자계산을 수행하는 가속기처럼 활용되는 구조를 이해하는 것이 현재의 실제 사용방식에 더 가깝습니다.
VQE에서는 이 과정이 반복된다
변분 양자 알고리즘인 VQE처럼 양자컴퓨터와 고전 컴퓨터를 반복해서 사용하는 방식에서는 이 구조가 더욱 분명합니다.
Classical Computer

Parameter θ₁

↓

Quantum Circuit

↓

QPU Execution

↓

Measurement

↓

Expectation Value

↓

Classical Optimizer

↓

Parameter θ₂

↓

QPU Execution

↓

Repeat
고전 최적화기가 새로운 파라미터를 계산하고, QPU가 해당 파라미터의 회로를 실행해 기대값을 반환하는 과정을 반복합니다.
따라서 현대의 많은 양자컴퓨팅 워크플로는 양자와 고전 계산을 분리해서 보기보다 서로 연결된 하나의 시스템으로 이해해야 합니다.
동적 양자회로에서는 실행 도중에도 고전 제어가 들어갈 수 있다
일반적인 회로에서는 모든 양자 게이트를 실행한 뒤 마지막에 측정합니다.
하지만 동적 양자회로에서는 회로 중간에 큐비트를 측정하고 그 고전 측정결과에 따라 다음 게이트를 결정할 수도 있습니다.
Quantum Operation

↓

Mid-Circuit Measurement

↓

Classical Bit

↓

if result = 1

↓

Apply Quantum Gate

↓

Continue Circuit
이 경우에는 QPU와 고전 제어 시스템 사이의 빠른 피드백이 중요해집니다.
양자 오류정정에서는 이 제어 구조가 더욱 복잡해진다
양자 오류정정에서는 데이터 큐비트와 보조 큐비트를 반복적으로 상호작용시킨 뒤 보조 큐비트를 측정합니다.
Data Qubits

↓

Quantum Interactions

↓

Ancilla Qubits

↓

Measurement

↓

Syndrome Bits

↓

Classical Decoder

↓

Correction / Frame Update
따라서 대규모 내결함성 양자컴퓨터에서는 QPU 성능뿐 아니라 측정과 고전 디코딩, 제어 시스템의 속도 역시 매우 중요한 요소가 됩니다.
시뮬레이터에서 실행하는 것과 실제 QPU는 무엇이 다를까?
양자 프로그램을 처음 공부할 때는 실제 QPU보다 시뮬레이터를 먼저 사용할 수 있습니다.
| 구분 | 이상적인 시뮬레이터 | 실제 QPU |
|---|---|---|
| 양자상태 | 고전 컴퓨터 내부의 수학적 계산 | 실제 물리적 양자계 |
| 게이트 | 행렬 계산으로 정확하게 구현 가능 | 물리적 제어신호로 구현 |
| 노이즈 | 이상적 모델에서는 없음 | 존재 가능 |
| 연결성 | 자유롭게 설정 가능 | 실제 하드웨어 구조의 제약 |
| Statevector 접근 | 가능한 시뮬레이터가 있음 | 일반적으로 직접 읽을 수 없음 |
| 측정 | 확률분포에서 Sampling 가능 | 실제 물리적 판독 |
시뮬레이터에서 잘 동작했던 회로가 실제 하드웨어에서 조금 다른 측정분포를 보일 수 있는 이유가 바로 이런 차이 때문입니다.
실제 QPU에서 실행하면 왜 결과가 항상 이상적이지 않을까?
실제 하드웨어에는 여러 가지 현실적인 오차가 존재할 수 있습니다.
- 큐비트 초기화 오류
- 단일 큐비트 게이트 오류
- 다중 큐비트 게이트 오류
- Decoherence
- Crosstalk
- 측정 오류
Ideal Program

↓

Ideal Circuit

↓

Ideal Probability


Real Execution

↓

Physical QPU

+

Noise / Imperfections

↓

Measured Distribution
따라서 실제 하드웨어를 사용할 때는 회로 최적화와 오류 억제, 오류 완화 같은 추가적인 기술이 함께 사용될 수 있습니다.
프로그램 실행과 회로 최적화는 어디에서 연결될까?
앞서 살펴본 것처럼 논리회로가 실제 QPU에 맞게 변환되는 과정에서 게이트와 SWAP이 추가될 수 있습니다.
실제 하드웨어에서는 회로가 길수록 더 많은 물리적 연산을 실행해야 하고 노이즈에 노출되는 시간도 늘어날 수 있습니다.
Logical Circuit

↓

Hardware Mapping

↓

Extra Operations

↓

Optimization

↓

Shorter ISA Circuit

↓

QPU Execution
그래서 양자 프로그램을 실제 하드웨어에서 실행하는 과정과 양자회로 최적화는 서로 떼어놓기 어려운 관계에 있습니다.
프로그램 코드가 실제 QPU까지 가는 과정을 한 번에 보자
| 단계 | 무엇이 일어날까 |
|---|---|
| 1. 프로그램 작성 | Python·Q# 등으로 알고리즘과 회로 작성 |
| 2. 논리회로 생성 | 큐비트와 양자 게이트 구조 생성 |
| 3. QPU 선택 | 실행할 실제 하드웨어 결정 |
| 4. Transpilation | Layout·Routing·Translation·Optimization 수행 |
| 5. ISA 회로 생성 | 대상 QPU가 실행 가능한 회로 완성 |
| 6. Job 제출 | 회로·Shots·파라미터·옵션 전송 |
| 7. Hardware Execution | 제어 시스템이 실제 물리 큐비트 조작 |
| 8. Measurement | 양자상태를 물리적으로 판독 |
| 9. Classical Result | 측정신호를 비트열로 변환 |
| 10. Result Return | Counts·확률·기대값 등을 사용자에게 반환 |
양자 프로그램 실행에서 고전 컴퓨터가 담당하는 부분
| 작업 | 주요 수행 주체 |
|---|---|
| 소스코드 작성 | 고전 컴퓨터 |
| 양자회로 생성 | 고전 컴퓨터 |
| Transpilation | 고전 컴퓨터 |
| Layout·Routing 계산 | 고전 컴퓨터 |
| Job 관리 | 고전 서비스·제어 시스템 |
| 양자상태 조작 | QPU |
| 물리적 측정 | QPU·Readout System |
| 측정신호 처리 | 고전 제어 시스템 |
| 통계·후처리 | 고전 컴퓨터 |
결국 QPU가 담당하는 부분은 전체 프로그램 실행흐름 가운데 양자상태를 직접 준비하고 변화시키고 측정하는 부분입니다.
포스팅 중간정리 : 오해와 실제의미
| 오해 | 실제 의미 |
|---|---|
| Python 코드가 QPU에서 직접 실행된다 | 코드로 회로를 만들고 하드웨어 실행형태로 변환한 뒤 QPU에 전달된다 |
| 논리 큐비트 q0가 실제 칩의 Q0와 항상 같다 | Layout 과정에서 다른 물리 큐비트에 매핑될 수 있다 |
| 사용자가 작성한 H·CNOT이 그대로 물리 게이트 하나로 실행된다 | 하드웨어의 지원 명령으로 변환될 수 있다 |
| 모든 큐비트는 서로 직접 연결되어 있다 | 실제 QPU에는 연결성 제약이 있을 수 있다 |
| Job을 제출하면 즉시 실행된다 | 클라우드 서비스에서는 대기상태를 거칠 수도 있다 |
| QPU가 Python 코드와 결과 분석까지 모두 처리한다 | 많은 작업은 고전 컴퓨터가 담당한다 |
| 측정하면 전체 Statevector가 반환된다 | 실제 QPU에서는 일반적으로 측정 비트열과 통계값을 얻는다 |
| 시뮬레이터 결과와 실제 QPU 결과는 항상 같다 | 실제 QPU에는 하드웨어 노이즈와 제약이 존재할 수 있다 |
직접 생각해보면 좋은 7가지 예제
- 논리 큐비트 q0와 실제 물리 큐비트 Q0가 항상 같지 않은 이유를 설명해보기
- 선형으로 연결된 Q0-Q1-Q2-Q3에서 Q0와 Q3 사이 CNOT이 필요할 때 어떤 문제가 생기는지 생각해보기
- 논리회로의 SWAP이 실제 Native Gate가 아니라면 회로가 어떻게 변할 수 있는지 생각해보기
- Transpilation까지 모두 QPU에서 실행하는 것이 아닌 이유를 설명해보기
- 1,000 Shots로 두 큐비트 회로를 실행했을 때 QPU가 몇 개의 측정 샘플을 반환하는지 생각해보기
- Statevector Simulator와 실제 QPU의 결과형태가 다른 이유를 설명해보기
- VQE에서 고전 컴퓨터와 QPU가 각각 어떤 작업을 담당하는지 구분해보기
양자 프로그램 실행과정 이해 점검 체크리스트
- 양자 프로그램 코드가 QPU에서 직접 실행되는 것이 아니라는 점을 이해했는가
- 논리 큐비트와 물리 큐비트를 구분할 수 있는가
- 실행할 QPU에 따라 Transpilation 결과가 달라질 수 있음을 알고 있는가
- Layout과 Routing의 역할을 설명할 수 있는가
- ISA Circuit이 무엇인지 이해했는가
- 논리 게이트가 하드웨어의 지원 명령으로 변환될 수 있음을 알고 있는가
- Job과 Shot의 차이를 구분할 수 있는가
- 제어 시스템이 논리 명령과 물리적 큐비트를 연결한다는 점을 이해했는가
- 실제 QPU에서는 측정을 통해 고전적인 결과를 얻는다는 점을 알고 있는가
- 양자컴퓨팅이 고전 컴퓨터와 QPU의 협업 구조라는 점을 설명할 수 있는가
자주 묻는 질문
Python 코드를 실제 양자컴퓨터가 직접 읽나요?
일반적으로 그렇지 않습니다. Python과 양자 SDK를 이용해 논리회로를 만들고 이를 대상 QPU의 명령집합과 연결성에 맞는 회로로 변환한 뒤 실행서비스를 통해 제출합니다.
Transpilation은 왜 반드시 필요한가요?
실제 QPU에는 사용할 수 있는 게이트와 큐비트 연결구조에 제한이 있기 때문입니다. 논리회로를 대상 하드웨어의 ISA에 맞게 변환해야 실제 실행이 가능합니다.
QPU는 회로 최적화도 직접 하나요?
일반적인 Transpilation과 회로 최적화는 QPU에서 양자연산으로 처리하기보다 고전 컴퓨팅 계층에서 수행됩니다. 최적화된 실행회로가 만들어진 뒤 실제 양자연산을 QPU가 수행합니다.
QPU에 제출하면 왜 바로 결과가 나오지 않을 수 있나요?
클라우드 양자컴퓨팅에서는 작업이 Job 형태로 관리되고 다른 작업이나 장치 운영상황에 따라 Queue에서 기다릴 수 있기 때문입니다.
실제 양자컴퓨터에서는 Statevector를 볼 수 없나요?
일반적인 실제 QPU에서는 전체 Statevector를 직접 읽어내는 방식이 아니라 측정을 통해 비트열과 통계적인 결과를 얻습니다. Statevector를 직접 확인하는 기능은 주로 시뮬레이터에서 활용합니다.
하나의 양자회로를 여러 번 실행하는 이유는 무엇인가요?
한 번의 측정에서는 하나의 측정결과만 얻기 때문입니다. 여러 Shot의 결과를 모아야 측정 확률분포나 기대값을 통계적으로 추정할 수 있습니다.
양자컴퓨터가 나중에는 고전 컴퓨터를 완전히 대체할까요?
현재의 양자컴퓨팅 실행구조에서는 고전 컴퓨터가 프로그램 작성, 회로 변환, Job 관리, 결과 분석 등을 담당하고 QPU는 특정 양자연산을 수행합니다. 따라서 두 시스템이 서로 역할을 나누는 구조가 매우 중요합니다.
이 포스팅에서 사용된 용어 정리
| 용어 | 의미 |
|---|---|
| Quantum Program | 양자회로와 실행조건을 정의하는 프로그램 |
| Logical Circuit | 알고리즘 수준에서 표현된 양자회로 |
| Backend / Target | 실행 대상으로 선택한 양자시스템 |
| Transpilation | 논리회로를 실제 하드웨어에 맞게 변환하는 과정 |
| Layout | 논리 큐비트를 물리 큐비트에 배치하는 과정 |
| Routing | 하드웨어 연결제약을 만족시키는 과정 |
| ISA Circuit | 대상 QPU의 지원 명령과 연결조건을 만족하는 회로 |
| Job | 양자컴퓨팅 서비스에 제출된 실행작업 |
| Control System | 실행 명령을 실제 물리적 큐비트 제어와 연결하는 시스템 |
| Measurement | 양자상태에서 고전적인 결과를 얻는 과정 |
마지막 핵심정리
양자컴퓨팅 프로그램이 실제 하드웨어에서 실행되는 과정은 단순히 코드를 작성한 뒤 QPU에 보내는 구조가 아닙니다.
먼저 고전 컴퓨터에서 양자 프로그램을 작성하고 알고리즘을 논리 양자회로로 표현합니다. 이후 실행할 QPU를 선택하면 Transpiler가 해당 장치의 물리 큐비트와 연결구조, 지원되는 명령집합을 고려해 회로를 다시 변환합니다.
Layout에서는 논리 큐비트를 실제 물리 큐비트에 배치하고 Routing에서는 필요한 다중 큐비트 연산이 가능하도록 연결성 문제를 해결합니다. Translation에서는 논리 게이트를 실제 QPU가 지원하는 명령으로 바꾸고 Optimization을 통해 불필요한 연산을 줄입니다.
이 과정을 거쳐 대상 QPU의 ISA를 만족하는 실행 가능한 회로가 준비되면 회로와 파라미터, Shot 수 등의 실행조건이 Job 형태로 제출됩니다.
실제 양자시스템에서는 제어장치가 회로의 명령을 물리적인 제어동작으로 변환해 큐비트 상태를 변화시키고, 계산이 끝나면 측정을 통해 양자상태를 고전적인 비트열로 바꿉니다.
마지막으로 여러 Shot에서 얻은 측정결과가 Counts나 확률, 기대값 같은 형태로 정리되어 다시 사용자의 고전 프로그램으로 돌아옵니다.
결국 양자 프로그램 실행의 핵심은 ‘코드 → QPU’라는 한 단계가 아니라 ‘고전 프로그램 → 논리회로 → 하드웨어 맞춤 변환 → 제어 시스템 → 물리적 양자연산 → 측정 → 고전 결과’라는 여러 계층이 연결되어 있다는 점입니다. 이 구조를 이해하면 Transpiler, Backend, Job, Shot 같은 용어가 왜 필요한지도 자연스럽게 연결됩니다. 실제 결과를 비교하려면 IBM QPU에서 1,000샷을 반복한 실험과 같은 회로를 서로 다른 QPU에서 실행한 실험을 참고하세요. 회로 제출부터 결과 수신까지의 서비스 흐름은 양자컴퓨터 클라우드 서비스의 운영 과정에서 자세히 설명합니다.
참고문헌
- IBM Quantum Documentation, Introduction to Transpilation
- IBM Quantum Documentation, Transpiler Stages
- IBM Quantum Documentation, Represent Quantum Computers for the Transpiler
- IBM Quantum Documentation, Executor and Sampler Execution Guides
- Microsoft Learn, Submit Quantum Programs to Azure Quantum
- Microsoft Learn, Submit QIR Circuits to Azure Quantum