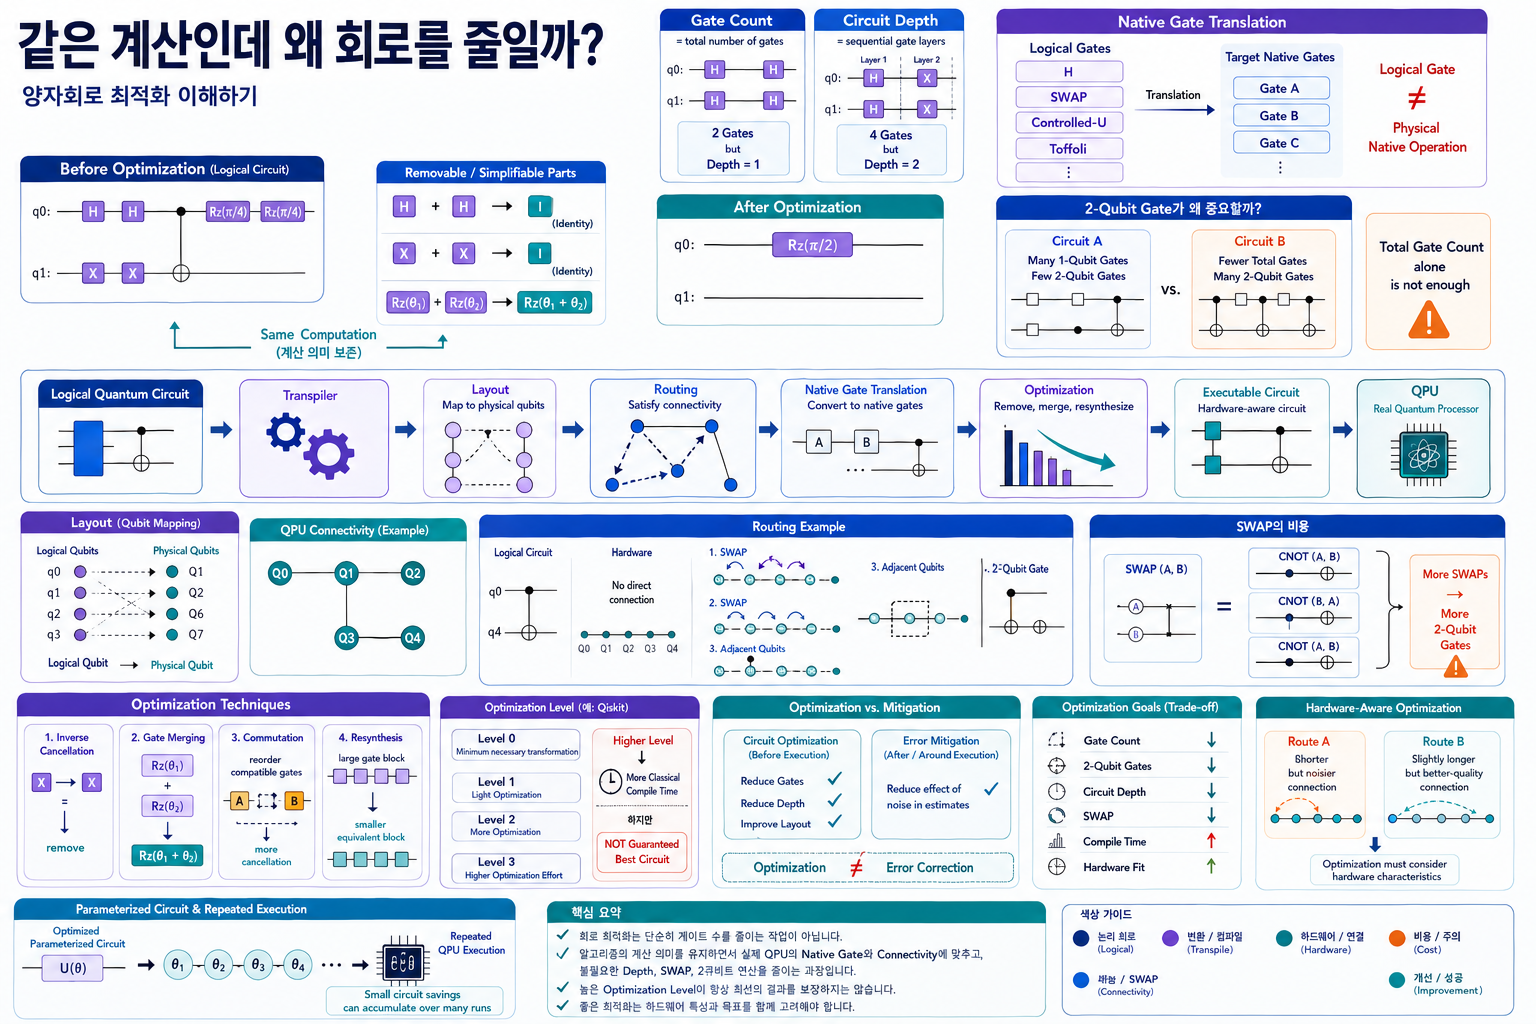
양자컴퓨팅에서 양자회로는 보통 컴퓨터의 입력 처럼 작성한 모습 그대로 실제 장치에서 실행되지 않는 경우가 많습니다. 양자 하드웨어마다 직접 지원 게이트가 다르고, 큐비트의 연결구조도 제한이 있기 때문인데요. 왜 이 얘기를 하는지 아래에서 확인하시죠.
양자회로는 왜 작성한 그대로 실행하지 않을까?
양자컴퓨터 프로그램을 처음 배우면 X, H, CNOT 같은 게이트를 연결해 원하는 회로를 만든 뒤 그대로 양자컴퓨터에 보내면 될 것처럼 보입니다.
하지만 실제 QPU에서는 사용자가 그린 논리적인 회로를 그대로 실행하기 어려운 경우가 많습니다. 양자 하드웨어마다 직접 지원하는 게이트가 다르고, 물리적 큐비트의 연결구조에도 제한이 있기 때문입니다.
또한 논리적으로는 같은 계산을 수행하는 회로라도 게이트 수와 회로 깊이, 2큐비트 연산의 수가 크게 다를 수 있습니다.
그래서 실제 양자컴퓨팅에서는 사용자가 작성한 회로를 QPU가 실행할 수 있는 형태로 변환하고 불필요한 연산을 줄이는 과정이 필요합니다. 이를 넓은 의미에서 양자회로 컴파일 또는 Transpilation과 연결해 이해할 수 있으며, 그 안에서 회로 최적화가 중요한 역할을 합니다.
Logical Quantum Circuit

↓

Transpilation / Compilation

↓

Qubit Layout

↓

Routing

↓

Native Gate Translation

↓

Circuit Optimization

↓

Executable Physical Circuit

↓

QPU
결국 회로 최적화의 목적은 계산의 의미를 유지하면서 실제 하드웨어에서 더 효율적으로 실행할 수 있는 회로를 만드는 것입니다.
| 구분 | 주요 의미 |
|---|---|
| Logical Circuit | 알고리즘 관점에서 작성한 이상적인 양자회로 |
| Transpilation | 회로를 실제 하드웨어 제약에 맞게 변환하는 전체 과정 |
| Layout | 논리 큐비트를 실제 물리적 큐비트에 배치 |
| Routing | 필요한 2큐비트 연산이 가능하도록 큐비트 위치 관계 조정 |
| Translation | 논리 게이트를 하드웨어가 지원하는 Native Gate로 변환 |
| Optimization | 불필요한 게이트·Depth·SWAP 등을 줄이는 과정 |
회로 최적화의 가장 기본적인 목표는 무엇일까
가장 단순하게 생각하면 원하는 양자연산을 더 적은 자원으로 수행하는 것이 목표입니다.
Before Optimization

same computation

많은 Gates
긴 Circuit Depth
많은 SWAP
많은 2-Qubit Gates

↓

Optimization

↓

After Optimization

same computation

fewer unnecessary operations
shorter execution path
better hardware fit
하지만 ‘게이트 개수가 가장 적은 회로’만 찾는 것이 항상 최선은 아닙니다.
예를 들어 총 게이트 수는 조금 많더라도 서로 독립적인 게이트를 동시에 실행할 수 있다면 회로 깊이는 더 짧아질 수 있습니다. 반대로 게이트 수가 적더라도 오류가 큰 2큐비트 게이트를 많이 사용하면 실제 QPU에서는 불리할 수 있습니다.
따라서 실제 최적화에서는 여러 목표 사이의 균형을 살펴봐야 합니다.
- 전체 게이트 수 감소
- 2큐비트 게이트 수 감소
- Circuit Depth 감소
- 불필요한 SWAP 감소
- 성능이 좋은 물리적 큐비트 선택
- 하드웨어 연결성에 맞는 배치
- 지원되는 Native Gate로 효율적인 변환
- 컴파일 시간과 최적화 품질 사이의 균형
회로가 길어지면 왜 실제 양자컴퓨터에서 불리할까?
이상적인 수학적 양자회로에서는 게이트를 정확하게 적용할 수 있다고 가정합니다.
하지만 실제 QPU의 큐비트와 제어장치는 완벽하지 않습니다. 게이트를 실행하는 동안 작은 제어오차가 생길 수 있고 큐비트는 주변 환경과 상호작용하면서 양자상태를 잃어갈 수 있습니다.
Ideal Circuit

Gate
→ Gate
→ Gate
→ Gate

perfect state evolution


Real QPU

Gate
→ small error possibility
→ Gate
→ more exposure to noise
→ Gate
→ decoherence continues
따라서 동일한 계산을 수행한다면 불필요하게 긴 회로보다는 필요한 연산을 더 짧고 효율적으로 수행하는 회로가 유리할 가능성이 높습니다.
Circuit Depth는 무엇을 의미할까?
게이트 수와 함께 자주 등장하는 지표가 Circuit Depth입니다.
Circuit Depth는 단순히 회로에 몇 개의 게이트가 있는지를 세는 숫자가 아니라, 서로 동시에 실행할 수 있는 연산을 고려했을 때 필요한 순차적인 연산 단계의 깊이를 의미합니다.
Circuit A

q0: ─H──X──────
q1: ─H─────X───

H gates can run together

↓

Depth can be smaller than
total gate count
따라서 총 게이트 수와 Circuit Depth는 같은 개념이 아닙니다.
| 지표 | 의미 |
|---|---|
| Gate Count | 회로에 포함된 전체 게이트 개수 |
| Circuit Depth | 순차적으로 필요한 연산 계층의 수 |
| 2-Qubit Gate Count | CNOT·CZ 등 여러 큐비트에 작용하는 게이트 수 |
| SWAP Count | Routing을 위해 추가된 상태 교환 연산 수 |
왜 2큐비트 게이트를 특히 줄이려고 할까?
실제 양자 하드웨어에서는 단일 큐비트 게이트보다 두 큐비트를 동시에 상호작용시키는 연산이 더 까다로운 경우가 많습니다.
그래서 CNOT이나 CZ 같은 2큐비트 게이트의 수는 회로가 실제 하드웨어에서 얼마나 효율적으로 실행될지를 판단할 때 중요한 지표로 사용됩니다.
Circuit A

1-Qubit Gates: many
2-Qubit Gates: few


Circuit B

1-Qubit Gates: fewer
2-Qubit Gates: many

↓

실제 QPU에서는
Circuit B가 반드시 더 좋은 것은 아님
따라서 양자회로 최적화에서는 단순히 전체 게이트 수만 줄이는 것보다 비용이 큰 다중 큐비트 연산을 줄이는 전략이 중요할 수 있습니다.
가장 쉬운 최적화는 “서로 상쇄되는 게이트를 없애는 것이다”
양자회로에는 연속해서 적용했을 때 서로 효과를 상쇄하는 게이트가 들어갈 수 있습니다.
대표적으로 X 게이트는 두 번 적용하면 원래 상태로 돌아옵니다.
X² = I


Before

|ψ⟩
→ X
→ X
→ |ψ⟩


After Optimization

|ψ⟩
────────
→ |ψ⟩
Hadamard도 마찬가지입니다.
H² = I

H
→ H

↓

remove
이처럼 서로 역연산 관계에 있는 연속된 게이트를 찾아 제거하면 계산결과를 바꾸지 않고도 게이트 수와 회로 깊이를 줄일 수 있습니다.
회전 게이트도 하나로 합칠 수 있다
같은 축을 중심으로 하는 연속적인 회전은 하나의 회전으로 합칠 수 있는 경우가 있습니다.
Rz(θ₁)

↓

Rz(θ₂)

↓

Rz(θ₁ + θ₂)
예를 들어 같은 큐비트에 여러 개의 단일 큐비트 회전이 연속적으로 배치되어 있다면 이를 더 적은 수의 기본 회전으로 다시 합성할 수 있습니다.
Google Quantum AI의 Cirq에서도 연속된 단일 큐비트 연산들을 하나의 PhasedXZ 형태로 병합하는 Transformer를 제공합니다.
하지만 실제 최적화는 단순한 게이트 삭제보다 복잡하다
논리적인 회로에서 눈에 보이는 불필요한 게이트 몇 개를 없애는 것으로 끝나지 않습니다.
실제 QPU에서 회로를 실행하려면 먼저 어떤 논리 큐비트를 어떤 물리적 큐비트에 배치할지를 정해야 합니다.
Logical Qubits

q0
q1
q2
q3

↓

Layout

↓

Physical Qubits

Q7
Q8
Q12
Q13
이를 Layout 또는 Qubit Mapping 문제라고 생각할 수 있습니다.
논리 큐비트와 물리 큐비트는 무엇이 다를까?
우리가 양자회로를 작성할 때 사용하는 q0, q1, q2는 알고리즘상의 논리적인 위치입니다.
실제 양자프로세서에는 하드웨어에 존재하는 물리적인 큐비트가 있으며 각 큐비트의 위치와 연결관계가 정해져 있습니다.
Logical Circuit

q0 ─●──
    │
q1 ─X──


Physical QPU

Q0 ─ Q1 ─ Q2
     │
     Q3
Transpiler는 논리 큐비트를 실제 장치의 어느 큐비트에 배치할지 결정해야 합니다.
하드웨어 연결성이 중요한 이유
논리적인 양자회로에서는 원하는 두 큐비트 사이에 자유롭게 CNOT을 사용할 수 있습니다.
Logical

q0 ─────●─────
        │
q4 ─────X─────
하지만 실제 QPU에서 모든 물리적 큐비트가 서로 직접 연결되어 있는 것은 아닙니다.
Physical Connectivity

Q0 ─ Q1 ─ Q2 ─ Q3 ─ Q4
예를 들어 Q0와 Q4 사이에 직접적인 2큐비트 게이트를 수행할 수 없다면 두 큐비트의 양자정보가 인접하도록 위치 관계를 바꾸어야 할 수 있습니다.
이 과정을 Routing이라고 합니다.
Routing 과정에서 왜 SWAP이 추가될까?
서로 직접 연결되어 있지 않은 큐비트 사이에서 2큐비트 연산이 필요하면 SWAP을 사용해 양자상태의 위치를 이동시킬 수 있습니다.
Need:

Q0 ↔ Q3 interaction


Hardware:

Q0 ─ Q1 ─ Q2 ─ Q3


Routing:

SWAP
↓
SWAP
↓
required qubits become adjacent
문제는 SWAP 역시 공짜가 아니라는 점입니다.
예를 들어 CNOT을 기본으로 사용하는 회로에서는 SWAP 하나를 세 개의 CNOT으로 분해할 수 있습니다.
SWAP(A,B)

=

CNOT(A,B)

↓

CNOT(B,A)

↓

CNOT(A,B)
따라서 Routing 때문에 SWAP이 여러 개 추가되면 원래 논리회로보다 실제 실행 회로의 2큐비트 게이트 수와 깊이가 크게 증가할 수 있습니다.
좋은 Layout이 중요한 이유도 SWAP 때문이다
논리 큐비트끼리 자주 상호작용하는 구조를 실제 하드웨어에서도 서로 가까운 물리 큐비트에 배치하면 불필요한 SWAP을 줄일 수 있습니다.
Bad Layout

logical q0 ↔ q1
frequent interaction

but

physical Q0 ─ Q1 ─ Q2 ─ Q3 ─ Q4

q0 = Q0
q1 = Q4

↓

Many SWAPs


Better Layout

q0 = Q1
q1 = Q2

↓

Direct interaction
즉 회로 최적화는 게이트 자체만 보는 문제가 아니라 알고리즘의 상호작용 구조와 실제 칩의 연결구조를 함께 보는 문제입니다.
Native Gate란 무엇일까?
우리는 회로에서 H, X, CNOT, SWAP, Toffoli 등 다양한 게이트를 자유롭게 사용할 수 있습니다.
하지만 실제 QPU는 모든 종류의 양자게이트를 물리적으로 직접 지원하는 것이 아닙니다.
각 하드웨어가 기본적으로 실행할 수 있는 제한된 연산 집합이 있으며 이를 Native Gate 또는 Basis Gate와 연결해 이해할 수 있습니다.
User Circuit

H
CNOT
SWAP
Toffoli
Arbitrary U

↓

Translation

↓

Hardware Native Gates

Gate A
Gate B
Gate C
...
따라서 Transpiler는 사용자가 작성한 게이트를 하드웨어가 실행할 수 있는 기본 연산의 조합으로 변환해야 합니다.
게이트를 Native Gate로 바꾸면 왜 회로가 더 길어질 수도 있을까?
논리회로에서 게이트 하나로 표현된 연산이 실제 하드웨어에서는 여러 개의 기본 게이트로 분해될 수 있기 때문입니다.
Logical Gate

Complex U

↓

Decomposition

↓

Native Gate 1

↓

Native Gate 2

↓

Native Gate 3

...
즉 하드웨어에 맞게 회로를 변환하는 Translation 단계는 실행 가능성을 확보하는 대신 게이트 수나 회로 깊이를 증가시킬 수도 있습니다.
그래서 Translation이 끝난 뒤 다시 불필요한 연산을 합치거나 제거하는 최적화 과정이 중요해집니다.
Transpilation과 Optimization은 같은 말일까?
완전히 같은 개념으로 볼 필요는 없습니다.
Transpilation은 논리적인 양자회로를 실제 하드웨어가 실행할 수 있는 회로로 바꾸는 넓은 과정이고, Optimization은 그 과정에서 회로의 효율을 개선하는 작업이라고 이해하면 쉽습니다.
Transpilation

├─ Initial simplification
├─ Layout
├─ Routing
├─ Translation
├─ Optimization
└─ Scheduling
실제 프레임워크에서는 여러 단계가 서로 긴밀하게 연결되어 수행되기 때문에 사용자는 이를 하나의 컴파일 과정처럼 접할 수 있습니다.
Optimization 과정에서는 어떤 작업이 이루어질까?
사용하는 컴파일러와 하드웨어에 따라 구체적인 방식은 달라지지만 다음과 같은 전략을 생각할 수 있습니다.
| 최적화 방법 | 예 |
|---|---|
| Inverse Cancellation | X-X, H-H처럼 서로 상쇄되는 연산 제거 |
| Gate Merging | 여러 단일 큐비트 회전을 하나의 회전으로 결합 |
| Commutation 활용 | 게이트 순서를 재배치해 제거 가능한 연산 발견 |
| Resynthesis | 여러 게이트 블록을 더 효율적인 게이트 조합으로 다시 합성 |
| Layout Optimization | 상호작용이 많은 큐비트를 가까운 물리 큐비트에 배치 |
| Routing Optimization | 필요한 SWAP 수 감소 |
| Measurement-aware Optimization | 측정결과에 영향을 주지 않는 일부 연산 제거 |
Commutation을 이용하면 왜 더 많은 게이트를 없앨 수 있을까?
어떤 두 양자게이트는 적용 순서를 바꾸어도 같은 결과를 만들 수 있습니다. 이런 경우 두 연산이 서로 commute한다고 표현합니다.
AB = BA

인 경우

A와 B의 순서를
바꿀 수 있음
겉보기에는 서로 떨어져 있어 제거할 수 없던 두 게이트가 중간 연산과 교환 가능하다면 순서를 재배치한 뒤 서로 붙여 상쇄할 수도 있습니다.
Before

A
↓
B
↓
A⁻¹


B와 A⁻¹의 순서 조정 가능

↓

A
↓
A⁻¹
↓
B

↓

B
이처럼 단순히 이웃한 게이트만 보는 것보다 회로의 수학적인 구조를 분석하면 더 많은 최적화 기회를 찾을 수 있습니다.
회로 블록을 통째로 다시 합성할 수도 있다
몇 개의 게이트를 하나씩 삭제하는 대신 여러 게이트가 만들어내는 전체 유니터리 변환을 분석한 뒤 더 짧은 게이트 조합으로 다시 만드는 방법도 사용할 수 있습니다.
Original Block

Gate A
↓
Gate B
↓
Gate C
↓
Gate D
↓
Gate E

=

Unitary U


Resynthesis

U

↓

Gate X
↓
Gate Y
↓
Gate Z
이런 Resynthesis는 특히 다중 큐비트 블록의 게이트 수를 줄일 때 중요한 최적화 기법이 될 수 있습니다.
최적화 전후 회로는 완전히 같은 모습이어야 할까?
그럴 필요는 없습니다.
중요한 것은 회로 그림이 같은지가 아니라 필요한 계산의 의미가 유지되는가입니다.
Circuit A

H
↓
Z
↓
H


Circuit B

X

두 회로가 같은 변환을 구현한다면

↓

Optimization 가능
실제로 HZH는 X와 같은 연산입니다.
H Z H = X
따라서 최적화된 회로는 원래 회로와 눈에 보이는 구조가 크게 달라질 수 있습니다.
정확히 같은 회로와 같은 결과를 내는 회로는 구분해야 한다
회로 최적화를 이야기할 때 ‘동일한 회로’라는 표현보다 ‘필요한 계산 의미를 보존하는 동등한 회로’라고 이해하는 편이 좋습니다.
일반적인 유니터리 회로에서는 동일한 유니터리 변환을 구현하는 것이 중요한 기준이 될 수 있고, 측정이 포함된 회로에서는 최종적으로 필요한 측정 통계를 보존하면 더 공격적인 최적화를 적용할 여지가 생길 수도 있습니다.
측정 직전의 불필요한 게이트도 제거할 수 있을까?
어떤 연산은 특정 측정기저의 최종 결과에 영향을 주지 않을 수 있습니다.
예를 들어 Z기저에서 바로 측정하기 직전의 일부 대각 연산은 측정확률을 바꾸지 않을 수 있습니다.
State

↓

Diagonal Phase Gate

↓

Z-basis Measurement


측정확률에 영향이 없다면

↓

해당 목적에서는
제거 가능할 수 있음
다만 이런 최적화는 회로의 목적과 측정방식을 정확하게 알고 적용해야 하며 모든 상황에서 임의로 제거할 수 있는 것은 아닙니다.
Qiskit의 Optimization Level은 무엇일까?
Qiskit에서는 Transpiler가 회로 최적화에 얼마나 많은 노력을 사용할지 Optimization Level로 설정할 수 있습니다.
| Optimization Level | 기본적인 의미 |
|---|---|
| 0 | 필수적인 하드웨어 변환 위주, 불필요한 최적화 최소화 |
| 1 | 비교적 가벼운 최적화 |
| 2 | 더 적극적인 Layout·Routing·게이트 최적화 |
| 3 | 더 많은 탐색과 재합성 등을 활용하는 높은 수준의 최적화 |
높은 Level일수록 일반적으로 더 많은 고전적인 컴파일 시간과 계산노력을 사용해 좋은 회로를 찾으려고 합니다.
Optimization Level ↑

↓

More Classical Compile Effort

↓

Potentially Better Circuit

하지만

↓

Longer Transpilation Time
Optimization Level 3이 항상 최고일까?
그렇다고 단정할 수는 없습니다.
최적화 문제 가운데 일부는 계산하기 매우 어렵기 때문에 실제 Transpiler는 휴리스틱과 확률적인 탐색 방법을 활용할 수 있습니다.
따라서 더 많은 최적화 노력을 사용한다고 모든 회로에서 반드시 더 짧거나 더 좋은 결과를 얻는 것은 아닙니다.
Higher Optimization Level

≠

Guaranteed Best Circuit


Actual result depends on:

Circuit structure
Hardware topology
Gate set
Optimization heuristic
Chosen objective
실제로는 여러 설정으로 Transpile한 뒤 2큐비트 게이트 수와 Depth, 실제 하드웨어 성능 등을 비교하는 방법이 필요할 수 있습니다.
회로 최적화와 고전 컴퓨터의 컴파일러는 비슷한 점이 있다
고전 프로그래밍 언어에서도 개발자가 작성한 코드는 그대로 CPU가 실행하지 않습니다.
High-Level Program

↓

Compiler

↓

Machine Instructions

↓

CPU
양자컴퓨팅도 비슷한 흐름을 갖습니다.
Quantum Algorithm

↓

Logical Circuit

↓

Quantum Compiler / Transpiler

↓

Hardware-aware Circuit

↓

QPU
다만 양자컴파일에서는 단순한 명령어 변환뿐 아니라 큐비트 연결성, 오류율, 양자상태의 coherence와 다중 큐비트 상호작용 같은 요소도 중요하다는 차이가 있습니다.
회로 최적화에서 Scheduling은 어떤 역할을 할까?
어떤 연산을 수행할 것인지 결정한 뒤에는 실제 시간축에서 언제 실행할지도 고려할 수 있습니다.
Gate A ──────

Gate B    ──────

Gate C           ──────

Time →
서로 독립적인 연산은 동시에 실행할 수 있고, 의존성이 있는 연산은 순차적으로 실행해야 합니다.
Scheduling은 실제 장치의 게이트 실행시간과 타이밍 제약을 고려해 회로의 시간적인 실행구조를 결정하는 단계입니다.
최적화가 잘되면 항상 실제 결과도 좋아질까
가능성은 높일 수 있지만 항상 그렇다고 단정해서는 안 됩니다.
게이트 수와 Depth가 줄어도 어떤 물리적 큐비트를 사용했는지, 해당 큐비트의 현재 오류 특성이 어떤지에 따라 실제 실행결과는 달라질 수 있습니다.
Shorter Circuit

+

Poor Physical Qubits

↓

may perform poorly


Slightly Longer Circuit

+

Better Qubit Mapping

↓

may perform better
그래서 실제 하드웨어를 대상으로 하는 최적화는 회로 자체뿐 아니라 장치 특성까지 함께 고려하는 Hardware-Aware Optimization이 중요합니다.
논리적으로 가장 짧은 경로가 실제로 가장 좋은 경로는 아닐 수 있다
두 물리적 큐비트 사이의 가장 짧은 연결경로가 항상 가장 높은 품질을 가진 것은 아닐 수 있습니다.
어떤 연결은 오류가 상대적으로 크고 다른 연결은 조금 더 멀더라도 더 안정적일 수 있습니다.
Route A

short

but
higher gate error


Route B

slightly longer

but
better-quality interactions
따라서 고급 최적화에서는 단순한 SWAP 개수뿐 아니라 하드웨어의 품질정보까지 최적화 목표에 활용할 수 있습니다.
회로 최적화와 오류 완화는 같은 개념일까?
서로 관련은 있지만 같은 개념은 아닙니다.
| 구분 | 주요 목적 |
|---|---|
| Circuit Optimization | 실행 전에 회로 구조를 더 효율적으로 변환 |
| Error Suppression | 실행 과정에서 노이즈의 영향을 억제 |
| Error Mitigation | 노이즈가 포함된 결과에서 오류 영향을 추정·완화 |
| Quantum Error Correction | 여러 물리적 큐비트를 이용해 논리 양자정보를 능동적으로 보호 |
회로를 짧게 만드는 것은 오류가 발생할 기회를 줄이는 데 도움이 될 수 있지만 그것만으로 모든 하드웨어 오류가 사라지는 것은 아닙니다.
양자 알고리즘을 설계할 때부터 최적화를 고려할 수도 있다
최적화는 완성된 회로를 마지막에 Transpiler에 넣을 때만 시작되는 작업은 아닙니다.
알고리즘이나 회로 구조를 설계할 때부터 특정 하드웨어의 연결성을 고려하면 처음부터 Routing 비용이 낮은 회로를 만들 수도 있습니다.
Approach A

Algorithm

↓

arbitrary logical circuit

↓

heavy routing


Approach B

Hardware-aware circuit design

↓

circuit already follows topology

↓

less routing overhead
즉 좋은 양자프로그램은 알고리즘 수준과 컴파일 수준, 하드웨어 수준을 완전히 따로 생각하기보다 서로 연결해 설계할수록 유리할 수 있습니다.
파라미터화된 양자회로에서도 최적화가 중요하다
VQE나 QAOA와 같은 변분 알고리즘에서는 같은 구조의 회로를 파라미터만 바꾸어 매우 여러 번 실행합니다.
Circuit U(θ)

↓

Transpile / Optimize

↓

θ₁ execution
θ₂ execution
θ₃ execution
θ₄ execution
...
반복 실행되는 기본 회로 구조에서 불필요한 Depth나 다중 큐비트 게이트를 줄이면 전체 알고리즘의 실행량에도 큰 영향을 줄 수 있습니다.
양자 오류정정 시대에도 회로 최적화가 필요할까?
필요합니다. 내결함성 양자컴퓨터에서는 논리 게이트 하나를 구현하기 위해 많은 물리적 연산이 필요할 수 있기 때문입니다.
따라서 불필요한 논리 게이트를 줄이고 효율적으로 회로를 합성하는 문제는 오류정정이 가능한 미래의 양자컴퓨터에서도 중요한 연구주제가 될 수 있습니다.
Logical Circuit Optimization

↓

Fewer Logical Operations

↓

Potentially Fewer
Fault-Tolerant Resources
회로 최적화 전후에 무엇을 확인하면 좋을까?
Transpiler가 회로를 최적화했다고 해서 단순히 결과를 믿고 끝내기보다 실제 변환된 회로를 살펴보는 것이 좋습니다.
- 전체 Gate Count가 얼마나 변했는가
- Circuit Depth가 얼마나 변했는가
- 2큐비트 게이트가 몇 개 사용되는가
- SWAP이 얼마나 추가되었는가
- 어떤 Physical Qubit에 배치되었는가
- 원하는 하드웨어 Native Gate로 변환되었는가
- 원래 회로의 계산 의미가 유지되는가
간단한 회로 최적화 예제를 보자
다음과 같은 논리회로가 있다고 가정해 보겠습니다.
Before

q0:
H → H → Rz(π/4) → Rz(π/4)

q1:
X → X
먼저 H 두 개는 서로 상쇄됩니다.
H H = I
X 두 개 역시 서로 상쇄됩니다.
X X = I
Rz 두 개는 하나로 합칠 수 있습니다.
Rz(π/4)
Rz(π/4)

↓

Rz(π/2)
따라서 단순화한 회로는 다음과 같이 표현할 수 있습니다.
After

q0:
Rz(π/2)

q1:
no operation
같은 계산 의미를 훨씬 적은 게이트로 구현한 것입니다.
Routing까지 포함하면 최적화 문제는 더 복잡해진다
이번에는 네 개의 논리 큐비트가 있다고 가정해 보겠습니다.
Logical Interactions

q0 ↔ q3
q0 ↔ q3
q0 ↔ q3

frequent interaction
실제 하드웨어가 다음처럼 연결되어 있다면
Q0 ─ Q1 ─ Q2 ─ Q3
q0와 q3를 각각 Q0와 Q3에 단순 배치할 경우 반복적인 상호작용마다 Routing 비용이 커질 수 있습니다.
반대로 자주 상호작용하는 두 논리 큐비트를 Q1과 Q2처럼 인접한 위치에 배치하면 추가 SWAP을 크게 줄일 수도 있습니다.
Optimization is not only

"remove gates"

but also

"choose where qubits live"
회로 최적화에서 어려운 점은 무엇일까?
가능한 큐비트 배치와 Routing 경로, 게이트 변환 방법의 조합은 큐비트 수와 회로 규모가 커질수록 매우 빠르게 증가합니다.
모든 경우를 하나씩 비교해 완벽한 최적 회로를 찾는 것은 현실적인 시간 안에 어려울 수 있습니다.
Many Logical Qubits

×

Many Physical Qubits

×

Many Possible Layouts

×

Many Routing Choices

×

Many Gate Decompositions

↓

Huge Optimization Search Space
그래서 실제 Transpiler에서는 휴리스틱 알고리즘을 이용해 제한된 시간 안에 좋은 해를 찾는 방식을 사용합니다.
왜 같은 회로를 Transpile해도 결과가 달라질 수 있을까?
일부 Layout과 Routing 알고리즘은 확률적이거나 휴리스틱한 탐색을 사용합니다.
따라서 같은 입력 회로와 같은 하드웨어를 사용하더라도 실행할 때마다 약간 다른 물리적 배치나 게이트 구성이 나올 수 있습니다.
Same Logical Circuit

↓

Transpile Run A

Circuit A


Same Logical Circuit

↓

Transpile Run B

Circuit B
재현 가능한 비교가 필요할 때는 사용하는 프레임워크에서 Transpiler의 Seed를 고정하는 방법을 사용할 수 있습니다.
Google Cirq에서는 회로 최적화를 어떻게 다룰까?
Cirq에서는 Transformer를 이용해 회로를 변환할 수 있습니다.
예를 들어 연속된 단일 큐비트 게이트를 하나의 연산으로 합치거나, 특정 하드웨어의 Target Gateset에서 사용할 수 있는 게이트로 회로를 변환할 수 있습니다.
Original Circuit

↓

Transformer

↓

Merge Gates
Drop Negligible Operations
Decompose Operations
Target Gateset Conversion

↓

Optimized Circuit
다만 이런 자동 최적화 역시 항상 수학적으로 가장 작은 회로를 찾아주는 것은 아니므로 최종 결과를 확인하는 것이 중요합니다.
회로 최적화를 한 번에 정리하면
| 단계 | 주요 질문 |
|---|---|
| 회로 단순화 | 없앨 수 있는 게이트가 있는가? |
| Gate Merging | 여러 회전을 하나로 합칠 수 있는가? |
| Layout | 어떤 논리 큐비트를 어느 물리 큐비트에 둘 것인가? |
| Routing | 연결되지 않은 큐비트의 상호작용을 어떻게 구현할 것인가? |
| Translation | 하드웨어 Native Gate로 어떻게 바꿀 것인가? |
| Resynthesis | 복잡한 게이트 블록을 더 짧게 만들 수 있는가? |
| Scheduling | 연산을 실제 시간축에서 언제 실행할 것인가? |
회로 최적화가 필요한 이유를 핵심만 정리하면
| 이유 | 핵심 내용 |
|---|---|
| 실제 QPU에서 실행하기 위해 | 논리회로를 하드웨어 제약에 맞게 변환해야 함 |
| 게이트 오류 영향을 줄이기 위해 | 불필요한 물리적 연산을 줄이는 것이 유리할 수 있음 |
| Decoherence 노출을 줄이기 위해 | Circuit Depth와 실행시간 감소가 중요 |
| 2큐비트 게이트를 줄이기 위해 | 실제 장치에서 상대적으로 비용이 큰 연산을 최소화 |
| SWAP을 줄이기 위해 | 좋은 Layout·Routing으로 추가 연산을 억제 |
| Native Gate에 맞추기 위해 | 장치에서 지원하는 연산집합으로 변환 |
| 전체 QPU 자원을 절약하기 위해 | 반복 실행되는 회로일수록 작은 개선도 누적 효과가 큼 |
자주 묻는 질문 정리
양자회로 최적화는 반드시 해야 하나요?
실제 QPU에서 실행하려면 최소한 해당 장치의 큐비트 연결구조와 지원 게이트에 맞추는 변환이 필요할 수 있습니다. 추가적인 최적화는 불필요한 게이트와 Routing 비용을 줄여 더 효율적인 실행을 만드는 데 도움을 줄 수 있습니다.
Transpilation과 Optimization은 같은 건가요?
Transpilation은 논리회로를 실제 하드웨어가 실행할 수 있도록 Layout, Routing, Translation, Optimization 등을 수행하는 더 넓은 과정으로 이해할 수 있습니다. Optimization은 그 안에서 회로의 효율을 개선하는 작업입니다.
Circuit Depth가 작으면 무조건 좋은가요?
일반적으로 짧은 회로는 장점이 있지만 Depth만으로 회로 품질을 판단할 수는 없습니다. 2큐비트 게이트 수, 사용한 물리 큐비트의 품질, SWAP과 Native Gate 구성 등도 함께 살펴봐야 합니다.
왜 SWAP 게이트를 줄이는 것이 중요한가요?
연결되지 않은 물리 큐비트 사이의 상호작용을 만들기 위해 SWAP이 추가될 수 있으며, SWAP 자체도 실제 하드웨어에서는 여러 기본 2큐비트 연산으로 구현될 수 있기 때문입니다. SWAP이 많아지면 실제 회로의 깊이와 오류 가능성이 증가할 수 있습니다.
Optimization Level 3을 항상 사용하면 되나요?
반드시 그렇지는 않습니다. 높은 수준은 더 많은 컴파일 시간과 탐색을 사용하지만 모든 회로에서 가장 좋은 결과를 보장하지 않습니다. 회로 규모와 필요한 컴파일 시간, 최종 2큐비트 게이트 수 등을 비교해 선택하는 것이 좋습니다.
회로 최적화를 하면 알고리즘의 답이 바뀌지 않나요?
정상적인 최적화는 필요한 계산 의미를 보존하면서 회로 구조를 바꾸는 것을 목표로 합니다. 다만 근사 최적화를 허용하는 특정 설정에서는 작은 근사오차를 받아들이면서 회로를 더 줄이는 방법도 존재할 수 있으므로 사용한 설정을 확인해야 합니다.
시뮬레이터에서도 회로 최적화가 필요한가요?
알고리즘 검증만을 위한 이상적인 시뮬레이션에서는 실제 QPU의 연결성과 Native Gate 제약을 반드시 적용할 필요는 없습니다. 하지만 특정 하드웨어에서 실행할 회로를 미리 분석하거나 실제 실행비용을 예측하려면 하드웨어를 대상으로 Transpile한 회로를 살펴보는 것이 중요합니다.
핵심 용어와 마무리 정리
| 용어 | 의미 |
|---|---|
| Circuit Optimization | 계산 의미를 유지하면서 회로 실행비용을 낮추는 과정 |
| Transpiler | 논리회로를 대상 하드웨어에 맞는 회로로 변환하는 도구 |
| Gate Count | 회로에 포함된 게이트 수 |
| Circuit Depth | 순차적으로 필요한 연산 계층의 깊이 |
| Layout | 논리 큐비트를 실제 물리 큐비트에 배치하는 과정 |
| Routing | 하드웨어 연결제약을 만족하도록 큐비트 상호작용 경로를 만드는 과정 |
| SWAP | 두 큐비트의 양자상태 위치를 교환하는 연산 |
| Native Gate | 대상 하드웨어가 기본적으로 지원하는 연산 |
| Translation | 회로 게이트를 대상 장치의 기본 게이트로 변환하는 단계 |
| Resynthesis | 게이트 블록을 분석해 더 효율적인 형태로 다시 합성하는 방법 |
양자컴퓨팅에서 회로 최적화가 필요한 가장 현실적인 이유는 우리가 작성한 논리회로와 실제 QPU가 실행할 수 있는 물리회로가 서로 다르기 때문입니다.
실제 장치에서는 지원되는 게이트 종류와 큐비트 연결구조가 제한되어 있기 때문에 논리 큐비트를 물리 큐비트에 배치하고, 필요한 상호작용을 위해 Routing을 수행하고, 게이트를 Native Gate로 변환해야 합니다.
이 과정에서 원래 회로에 없던 SWAP이나 추가적인 게이트가 생길 수 있습니다. 따라서 컴파일 과정에서는 다시 불필요한 연산을 제거하고 회전을 합치며 다중 큐비트 게이트 블록을 재합성해 회로를 줄이려는 작업이 이루어집니다.
특히 실제 QPU에서는 2큐비트 게이트와 긴 회로 깊이가 중요한 부담이 될 수 있기 때문에 단순한 전체 게이트 수보다 CNOT·CZ 같은 다중 큐비트 연산과 Routing 비용까지 함께 살펴봐야 합니다.
다만 가장 짧은 회로가 항상 실제 하드웨어에서 최고의 결과를 내는 것은 아닙니다. 어떤 물리 큐비트와 연결을 선택했는지, 해당 장치의 현재 오류 특성이 어떤지에 따라 결과가 달라질 수 있기 때문입니다.
결국 좋은 양자회로 최적화는 단순한 ‘게이트 삭제’가 아닙니다. 알고리즘의 의미를 유지하면서 논리회로를 실제 QPU 구조에 맞게 배치하고, Routing과 게이트 변환에서 생기는 추가 비용을 줄여 전체 계산을 효율적으로 실행할 수 있도록 만드는 과정이라고 이해하는 것이 좋습니다.
참고문헌
- IBM Quantum Documentation, Set Transpiler Optimization Level
- IBM Quantum Documentation, Transpiler Stages
- IBM Quantum Documentation, Compare Transpiler Settings
- IBM Quantum Documentation, Transpiler API
- Google Quantum AI, Cirq Basics – Transformers
- Google Quantum AI, Circuit Transformers
- Google Quantum AI, Qubit Routing
- Google Quantum AI, Compilation Target Gateset