
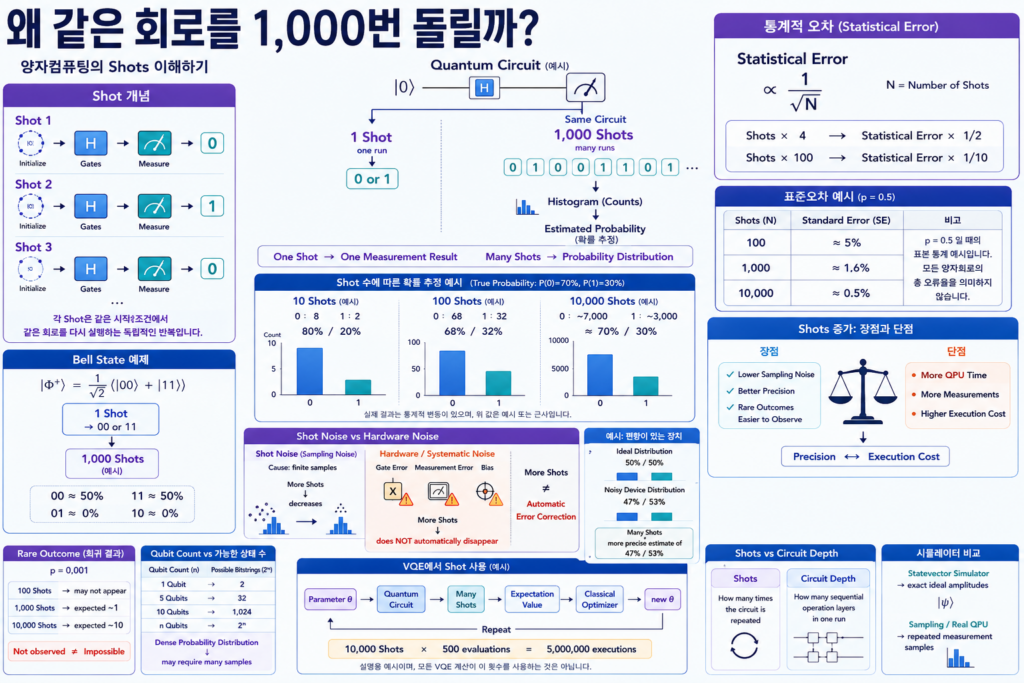
양자컴퓨팅은 우리가 흔히 사용하는 컴퓨터와 달리 한 번 실행한다고해서 정확한 확률을 알 수 없습니다. 즉, 실제 확률이나 기대값을 알아내려면 같은 회로를 여러 번 실행해야 하는데요. 이를 shot이라고 합니다. 아래에서 Shot에 대해 알아봅니다.
입문자를 위한 핵심 용어정리
| 용어 | 의미 |
|---|---|
| Shot | 양자회로를 한 번 실행하고 측정하는 반복 단위 |
| Sampling | 반복 측정으로 결과의 통계적 분포를 추정하는 과정 |
| Counts | 각 비트열이 측정된 횟수 |
| Probability Distribution | 각 측정결과가 나타날 확률 |
| Shot Noise | 유한한 샘플 수 때문에 발생하는 통계적 변동 |
| Standard Error | 표본으로 추정한 값의 통계적 불확실성을 나타내는 값 |
| Expectation Value | 측정 가능한 관측량의 확률가중 평균 |
| Sampler | 회로 측정결과의 분포를 Sampling하는 계산 인터페이스 |
| Estimator | 관측량의 기대값을 추정하는 계산 인터페이스 |
| Hardware Noise | 실제 큐비트·게이트·측정 과정에서 발생할 수 있는 물리적 오류 |
양자컴퓨터는 왜 같은 회로를 여러 번 실행할까
일반적인 컴퓨터 프로그램은 같은 입력을 넣으면 같은 결과를 얻는 경우가 많습니다. 그래서 양자컴퓨터를 처음 접하면 양자회로도 한 번 실행한 뒤 결과를 확인하면 된다고 생각하기 쉽습니다.
하지만 양자컴퓨팅에서는 하나의 회로를 수백 번, 수천 번 또는 그 이상 반복해서 실행하는 경우가 매우 흔합니다. 양자상태를 측정했을 때 얻는 결과가 확률적으로 나타나기 때문입니다.
양자회로를 처음부터 준비해 게이트를 실행하고 마지막으로 측정결과 하나를 얻는 한 번의 실행을 보통 하나의 Shot이라고 부릅니다.
1 Shot

Initialization

↓

Quantum Gates

↓

Measurement

↓

one classical result
한 번의 Shot에서는 큐비트의 전체 확률분포가 출력되지 않습니다. 측정결과 하나만 얻기 때문에 실제 양자상태가 어떤 확률구조를 가지고 있는지 알아보려면 동일한 회로를 반복 실행해 통계를 모아야 합니다.
| 용어 | 의미 |
|---|---|
| Shot | 양자회로를 실행하고 측정결과를 얻는 한 번의 반복 |
| Shots | 같은 회로를 반복 실행한 횟수 |
| Measurement Result | 한 Shot에서 얻는 0·1 또는 비트열 |
| Counts | 각 측정결과가 몇 번 나왔는지 집계한 값 |
| Probability Estimate | Counts를 전체 Shot 수로 나누어 추정한 확률 |
한 번의 측정에서는 왜 확률을 알 수 없을까
한 큐비트가 다음과 같은 상태에 있다고 생각해 보겠습니다.
|ψ⟩ =

√0.7|0⟩
+
√0.3|1⟩
계산 기저에서 측정했을 때 이론적으로 0이 나올 확률은 70%, 1이 나올 확률은 30%입니다.
P(0) = 0.7

P(1) = 0.3
하지만 실제로 회로를 한 번 실행하면 다음 두 결과 중 하나만 얻습니다.
Shot 1

→ 0

또는

→ 1
0이 한 번 나왔다고 해서 원래 확률이 100%였다고 결론 내릴 수 없고, 1이 나왔다고 해서 원래 확률이 100%였다고 볼 수도 없습니다.
확률을 알아내려면 같은 상태를 다시 준비하고 같은 회로를 여러 번 반복해서 측정해야 합니다.
Shots를 늘리면 어떤 정보가 보이기 시작할까
위의 70대30 상태를 여러 번 측정한다고 생각해 보겠습니다.
10 Shots

0 → 8회
1 → 2회

추정:
80% / 20%


100 Shots

0 → 68회
1 → 32회

추정:
68% / 32%


10,000 Shots

0 → 약 7,000회
1 → 약 3,000회

추정:
약 70% / 30%
실제로 얻는 숫자는 매번 조금씩 달라질 수 있지만 일반적으로 반복 횟수가 늘어날수록 관찰된 빈도는 실제 측정확률에 가까워지는 경향을 보입니다.
IBM Quantum의 Sampler도 실제 양자장치에서 회로를 여러 번 실행하고 각 Shot에서 얻은 비트열을 이용해 측정 확률분포를 추정하는 방식으로 동작합니다.
Shot 하나에서는 실제로 무엇이 출력될까
여러 큐비트를 측정한다면 한 Shot에서 하나의 비트열을 얻습니다.
3-Qubit Circuit

↓

1 Shot

↓

101
같은 회로를 10번 실행하면 다음처럼 여러 결과가 쌓일 수 있습니다.
Shot 1  → 000
Shot 2  → 101
Shot 3  → 101
Shot 4  → 001
Shot 5  → 101
Shot 6  → 000
Shot 7  → 111
Shot 8  → 101
Shot 9  → 000
Shot 10 → 101
이를 결과별로 집계하면 Counts가 됩니다.
101 → 5

000 → 3

001 → 1

111 → 1
Shot 수로 나누면 측정 확률을 추정할 수 있습니다.
Bell 상태도 한 번 측정해서는 확인하기 어렵다
대표적인 두 큐비트 얽힘 상태를 생각해 보겠습니다.
|Φ+⟩ =

1/√2(
|00⟩ + |11⟩
)
계산 기저에서 이 상태를 한 번 측정하면 결과는 00 또는 11 가운데 하나입니다.
1 Shot

→ 00

또는

→ 11
00 한 번만 보고서는 00이 항상 나오는 상태인지, 00과 11이 절반씩 나오는 상태인지 구별하기 어렵습니다.
회로를 반복 실행하면 비로소 다음과 같은 통계가 보이기 시작합니다.
1,000 Shots

00 → 약 500회

11 → 약 500회

01 → 거의 없음

10 → 거의 없음
따라서 양자상태의 측정 특성을 확인하려면 여러 Shot에서 나타나는 결과의 분포와 상관관계를 함께 살펴봐야 합니다.
Shot 수가 늘어나면 통계적 오차는 어떻게 줄어들까
측정확률 p를 N번의 Shot으로 추정한다고 하겠습니다.
결과가 1인 횟수를 k라고 하면 측정확률의 추정치는 다음과 같습니다.
p̂ = k / N
이때 단순한 0과 1 측정의 표준오차는 다음과 같은 형태로 나타납니다.
Standard Error

≈

√[
p(1-p)
───────
   N
]
중요한 부분은 오차가 Shot 수 N 자체에 반비례하는 것이 아니라 √N에 반비례한다는 것입니다.
Statistical Error

∝

1 / √N
Shots를 4배 늘리면 오차는 절반 정도로 줄어든다
1/√N 관계 때문에 반복 횟수를 두 배 늘린다고 통계적 오차가 절반이 되는 것은 아닙니다.
Shots × 4

↓

Statistical Error × 1/2


Shots × 100

↓

Statistical Error × 1/10
즉 더 정확한 결과를 얻기 위해 필요한 Shot 수는 생각보다 빠르게 증가합니다.
| Shots | p=0.5일 때 표준오차 | 대략적인 특징 |
|---|---|---|
| 100 | 약 5.0% | 대략적인 경향 확인 |
| 1,000 | 약 1.58% | 확률분포가 비교적 안정됨 |
| 10,000 | 약 0.50% | 더 정밀한 확률 추정 |
| 100,000 | 약 0.16% | 통계오차는 작아지지만 실행비용 증가 |
이 수치는 이상적인 표본오차를 설명하기 위한 예시입니다. 실제 양자 하드웨어에서는 게이트 오류와 측정오류 같은 다른 요인도 함께 존재할 수 있습니다.
왜 Shots를 무한정 늘리지 않을까
Shot 수가 많을수록 통계적으로 더 안정적인 결과를 얻을 수 있다면 가능한 한 많이 실행하면 좋을 것처럼 보입니다.
하지만 반복 횟수에는 비용이 따릅니다.
- QPU를 더 오래 사용해야 합니다.
- 전체 프로그램 실행시간이 증가합니다.
- 더 많은 측정 데이터가 생성됩니다.
- 파라미터가 많은 알고리즘에서는 총 실행 횟수가 급격히 증가할 수 있습니다.
- 일정 수준 이후에는 추가 Shot으로 얻는 정확도 개선 폭이 작아집니다.
More Shots

↓

Lower Sampling Noise

하지만

↓

More QPU Time
+
More Data
+
More Cost
따라서 실제 양자컴퓨팅에서는 정확도와 실행비용 사이에서 적절한 Shot 수를 선택해야 합니다.
100 Shots와 10,000 Shots의 차이를 생각해보자
실제 확률이 정확히 50%인 큐비트를 측정한다고 가정하겠습니다.
True Probability

P(0) = 0.5
P(1) = 0.5
100번 실행하면 우연히 다음과 같은 결과가 나올 수 있습니다.
100 Shots

0 → 56
1 → 44

Estimated Probability

56% / 44%
10,000번 실행했다면 결과가 다음처럼 나타날 수 있습니다.
10,000 Shots

0 → 5,031
1 → 4,969

Estimated Probability

50.31% / 49.69%
두 결과 모두 가능한 표본이지만 많은 Shot을 사용한 결과가 실제 확률을 더 안정적으로 추정할 가능성이 높습니다.
하지만 Shots를 늘려도 사라지지 않는 오류가 있다
여기에서 매우 중요한 구분이 있습니다.
Shot 수를 늘렸을 때 주로 줄어드는 것은 유한한 표본을 사용해서 생기는 통계적 불확실성입니다.
반면 실제 장치가 일정한 방향으로 잘못된 결과를 내고 있다면 반복 횟수를 늘린다고 그 오류가 자동으로 없어지는 것은 아닙니다.
Sampling Error

More Shots
→ decreases


Systematic / Hardware Error

More Shots
→ does not automatically disappear
측정오류가 있다면 Shots를 늘렸을 때 어떻게 될까
예를 들어 이상적인 회로에서는 0이 50%, 1이 50% 나와야 하지만 측정장치가 1을 조금 더 자주 읽는 편향을 가지고 있다고 생각해 보겠습니다.
Ideal

0 → 50%
1 → 50%


Noisy Hardware

0 → 47%
1 → 53%
이 상황에서 Shot을 계속 늘리면 50대50으로 수렴하는 것이 아니라 실제 장치가 만들어내는 47대53 분포를 더 정밀하게 측정할 가능성이 있습니다.
즉 많은 Shot은 ‘틀린 장치를 정답으로 만들어주는 방법’이 아니라 현재 장치에서 발생하는 확률분포를 더 정확하게 추정하는 방법입니다.
Shot Noise와 Hardware Noise는 무엇이 다를까
| 구분 | Shot Noise | Hardware Noise |
|---|---|---|
| 원인 | 유한한 측정 샘플 | 게이트·측정·환경 등의 물리적 오류 |
| Shots 증가 효과 | 감소 | 자동으로 제거되지 않음 |
| 대표 대응 | 반복 횟수 증가 | 캘리브레이션·오류 억제·오류 완화 등 |
| 극단적으로 많은 Shots | 통계적 변동 감소 | 노이즈가 있는 실제 분포를 정밀하게 추정 |
실제 실험에서는 이 두 종류의 오차가 동시에 존재할 수 있기 때문에 단순히 Shot 수만 보고 결과의 신뢰성을 판단해서는 안 됩니다.
희귀한 측정결과를 찾을 때는 더 많은 Shots가 필요하다
어떤 결과가 50% 확률로 나타난다면 비교적 적은 Shot으로도 쉽게 관찰할 수 있습니다.
하지만 발생확률이 0.1%, 즉 0.001인 결과라면 상황이 달라집니다.
Rare Result

p = 0.001


100 Shots

Expected Count ≈ 0.1


1,000 Shots

Expected Count ≈ 1


10,000 Shots

Expected Count ≈ 10
적은 Shot에서는 실제 확률이 0이 아니더라도 한 번도 관찰되지 않을 수 있습니다.
따라서 관심 있는 상태가 매우 작은 확률을 가진다면 일반적인 주요 결과를 확인할 때보다 더 많은 샘플이 필요할 수 있습니다.
측정결과가 한 번도 나오지 않았다고 확률이 0인 것은 아니다
예를 들어 1,000 Shots를 실행했는데 특정 비트열이 한 번도 나오지 않았다고 생각해 보겠습니다.
Observed Count

101101 → 0 / 1000
이 결과만으로 해당 상태의 실제 측정확률이 정확히 0이라고 단정할 수는 없습니다.
확률이 매우 작아서 현재 Shot 수에서는 한 번도 표본으로 선택되지 않았을 수도 있기 때문입니다.
양자 측정결과를 해석할 때는 ‘관측되지 않음’과 ‘불가능함’을 구분해야 합니다.
큐비트가 많아지면 Shots 문제도 어려워질 수 있다
n개의 큐비트를 계산 기저에서 측정하면 가능한 비트열의 수는 2ⁿ개입니다.
1 Qubit

2 outcomes


5 Qubits

32 outcomes


10 Qubits

1,024 outcomes


20 Qubits

1,048,576 outcomes


n Qubits

2ⁿ outcomes
가능한 모든 상태가 비슷한 확률을 가지는 매우 조밀한 분포를 정확하게 추정하려 한다면 필요한 샘플 수가 급격히 증가할 수 있습니다.
그래서 실제 양자 알고리즘에서는 반드시 전체 2ⁿ개의 확률을 모두 정확하게 복원하려 하기보다 필요한 비트열이나 기대값, 특정 관측량 같은 제한된 정보를 효율적으로 추출하도록 설계하는 것이 중요합니다.
Sampler와 Estimator는 Shots를 어떻게 사용할까
양자컴퓨팅에서 회로 실행결과를 이용하는 대표적인 방식으로 Sampling과 Expectation Value Estimation을 생각할 수 있습니다.
| 방식 | 주요 목적 |
|---|---|
| Sampler | 각 비트열이 나올 확률분포를 추정 |
| Estimator | 관측량의 기대값을 추정 |
Sampler에서는 각 Shot에서 얻은 비트열을 모아 결과별 빈도를 계산합니다.
Quantum Circuit

↓

Many Shots

↓

Bitstrings

00
11
00
00
11
...

↓

Probability Distribution
Estimator에서는 반복 측정을 이용해 특정 물리량이나 비용함수 계산에 필요한 기대값을 추정할 수 있습니다.
Quantum State

↓

Measure Observable

↓

Many Samples

↓

Average

↓

Expectation Value
기대값에서도 Shots가 중요한 이유
관측값이 +1 또는 −1로 나오는 측정을 생각해 보겠습니다.
기대값은 여러 측정결과의 평균으로 추정할 수 있습니다.
Measurements

+1
+1
−1
+1
−1
...

↓

Average

↓

Estimated Expectation Value
표본 수가 적다면 이 평균이 크게 흔들릴 수 있지만 Shot 수가 많아질수록 일반적으로 통계적인 불확실성이 줄어듭니다.
기대값 추정의 표준오차 역시 기본적으로 다음과 같은 형태의 1/√N 관계를 가집니다.
Standard Error

≈

σ / √N

σ = 측정값의 표준편차
N = Shots
IBM Quantum의 Estimator 문서에서도 Shot 기반 기대값 추정의 ensemble standard error를 표준편차를 Shot 수의 제곱근으로 나눈 형태로 설명합니다.
정밀도를 두 배 높이려면 왜 훨씬 많은 실행이 필요할까
통계오차가 대략 1/√N으로 감소한다고 생각해보면 원하는 오차를 절반으로 줄이기 위해서는 Shot 수를 네 배 정도 사용해야 합니다.
현재

N Shots

Standard Error ≈ ε


목표

Standard Error ≈ ε / 2

필요:

약 4N Shots
이것이 양자 알고리즘에서 지나치게 높은 측정 정밀도를 요구하면 전체 계산량이 크게 증가하는 이유 가운데 하나입니다.
VQE에서는 Shot 수가 전체 실행량에 큰 영향을 준다
VQE와 같은 변분 양자 알고리즘에서는 파라미터를 조금씩 바꾸면서 양자회로를 반복적으로 실행합니다.
Parameter θ₁

↓

Quantum Circuit

↓

Many Shots

↓

Cost(θ₁)

↓

Classical Optimizer

↓

Parameter θ₂

↓

Quantum Circuit

↓

Many Shots

↓

Cost(θ₂)

↓

반복
한 번의 비용함수 계산에 10,000 Shots가 필요하고 최적화 과정에서 회로를 수백 번 평가해야 한다면 전체 QPU 실행 횟수는 매우 커질 수 있습니다.
10,000 Shots

×

500 parameter evaluations

=

5,000,000 circuit executions
실제 알고리즘에서는 여러 측정기저와 관측량까지 필요할 수 있으므로 Shot 관리가 전체 실행비용을 결정하는 중요한 요소가 됩니다.
그렇다면 처음부터 많은 Shots를 사용하면 되지 않을까
항상 효율적인 방법은 아닙니다.
예를 들어 알고리즘의 초기 최적화 단계에서는 파라미터가 좋은 방향인지 나쁜 방향인지 대략적인 정보만 있어도 충분할 수 있습니다.
이 단계부터 매우 많은 Shot을 사용하면 아직 필요하지 않은 정밀도를 얻기 위해 많은 계산자원을 소비할 수 있습니다.
Early Optimization

few / moderate shots

↓

rough direction


Near Final Solution

more shots

↓

higher precision
그래서 문제에 따라 계산 진행상황이나 원하는 정확도에 맞춰 Shot 수를 조정하는 전략을 생각할 수 있습니다.
Shot 수는 회로 깊이와 같은 개념이 아니다
입문할 때 Shot과 회로 깊이를 혼동하기 쉽습니다.
| 구분 | 의미 |
|---|---|
| Shots | 같은 회로를 몇 번 반복 실행하는가 |
| Circuit Depth | 한 번의 회로 실행에서 순차적으로 필요한 연산 단계 |
| Gate Count | 회로에 포함된 게이트의 개수 |
| Qubit Count | 회로가 사용하는 큐비트의 수 |
Circuit A

Depth = 20

Shots = 1,000


의미:

20단계 정도의 회로를

1,000번 반복 실행
Shot을 늘린다고 한 번의 양자회로 자체가 더 깊어지는 것은 아닙니다. 같은 회로를 처음부터 다시 실행하는 횟수가 증가하는 것입니다.
Shots와 Job 수도 구분해야 한다
하나의 Job 안에서 하나 이상의 회로나 많은 Shot을 실행할 수 있기 때문에 Job 수와 Shot 수 역시 같은 개념이 아닙니다.
1 Job

Circuit A
→ 1,000 Shots

Circuit B
→ 1,000 Shots

Circuit C
→ 2,000 Shots
실제 클라우드 양자컴퓨팅 환경에서는 여러 회로를 한 번에 묶어 전송하거나 파라미터를 Sweep하는 방식으로 실행효율을 높이기도 합니다.
회로를 반복할 때 매번 처음부터 시작할까
개념적으로 각 Shot은 동일한 초기조건에서 같은 양자회로를 다시 실행하는 독립적인 실험이라고 이해하는 것이 좋습니다.
Shot 1

Initialize
→ Circuit
→ Measure


Shot 2

Initialize
→ Circuit
→ Measure


Shot 3

Initialize
→ Circuit
→ Measure
이전 Shot에서 1이 나왔다고 다음 Shot이 반드시 1에서 시작하는 것이 아닙니다. 반복 측정의 통계적 의미를 유지하려면 각 실행에서 동일한 상태 준비와 회로 조건이 재현되어야 합니다.
시뮬레이터에서도 Shots가 필요할까
양자 시뮬레이터에는 두 가지 관점을 구분할 필요가 있습니다.
상태벡터 시뮬레이터는 이상적인 경우 최종 양자상태의 확률진폭 자체를 계산할 수 있습니다.
Statevector Simulation

↓

|ψ⟩

↓

exact amplitudes

↓

exact ideal probabilities
반면 실제 하드웨어처럼 측정결과를 Sampling하려면 시뮬레이터에서도 반복 횟수를 지정할 수 있습니다.
Sampling Simulator

Circuit

↓

1,000 repetitions

↓

bitstrings

↓

histogram
Google Quantum AI의 Cirq에서도 run 방식의 repetitions는 회로를 몇 번 Sampling할지를 지정하며, 상태벡터를 직접 계산하는 simulate 방식과 구분됩니다.
이상적인 시뮬레이터에서 1,000 Shots와 실제 QPU의 1,000 Shots는 무엇이 다를까
이상적인 시뮬레이터에서는 지정한 이상적 양자상태의 확률분포에서 표본을 추출합니다.
실제 QPU에서는 하드웨어의 물리적 큐비트를 준비하고 게이트를 실행한 뒤 측정하기 때문에 노이즈와 실제 장치 특성이 결과에 포함될 수 있습니다.
| 항목 | 이상적 Sampling Simulator | 실제 QPU |
|---|---|---|
| Shot | 확률분포에서 표본 추출 | 실제 회로 준비·실행·측정 |
| Sampling Noise | 존재 | 존재 |
| 게이트 오류 | 이상적 모델에서는 없음 | 존재 가능 |
| 측정 오류 | 이상적 모델에서는 없음 | 존재 가능 |
| 많은 Shots의 효과 | 이상적 분포에 접근 | 실제 장치가 만드는 분포를 더 정확히 추정 |
Shots는 많을수록 항상 좋은가
정확히 말하면 통계적 추정만 놓고 보면 일반적으로 더 많은 Shot이 유리합니다. 하지만 실제 계산 전체를 생각하면 무조건 많을수록 좋은 것은 아닙니다.
| Shots가 적을 때 | Shots가 많을 때 |
|---|---|
| 실행시간이 짧음 | 통계적인 결과가 안정됨 |
| 대략적인 결과를 빠르게 확인 가능 | 작은 확률 차이를 구분하기 쉬움 |
| Sampling Noise가 큼 | Sampling Noise가 감소 |
| 희귀 상태를 놓치기 쉬움 | 희귀 상태를 관찰할 가능성 증가 |
| 최적화 초기단계 등에 유용할 수 있음 | 정밀한 최종 평가 등에 유용 |
| QPU 사용량이 적음 | QPU 사용량과 실행시간 증가 |
적절한 Shot 수는 어떻게 결정할까
모든 양자회로에 적용되는 하나의 정답은 없습니다.
필요한 Shot 수는 다음과 같은 조건에 따라 달라질 수 있습니다.
- 얼마나 작은 확률 차이를 구분해야 하는가
- 최종 결과에 필요한 통계적 정밀도는 어느 정도인가
- 관심 있는 상태가 흔한가 희귀한가
- 몇 개의 관측량을 측정해야 하는가
- 양자회로를 몇 번 반복 평가해야 하는가
- 사용할 수 있는 QPU 시간과 비용은 어느 정도인가
- 현재 계산이 탐색 단계인지 최종 정밀 측정 단계인지
즉 Shot 수를 정할 때는 단순히 ‘많으면 좋다’가 아니라 필요한 정확도를 얻기 위해 최소한 어느 정도의 실행량이 필요한지를 생각하는 것이 중요합니다.
양자 알고리즘의 성능을 비교할 때 Shots를 함께 봐야 하는 이유
두 알고리즘이 모두 정답 확률 90%를 얻었다고 하더라도 측정 횟수가 다르다면 결과에 대한 통계적인 신뢰도 역시 다를 수 있습니다.
Algorithm A

90 / 100
→ 90%


Algorithm B

9,000 / 10,000
→ 90%
두 결과의 비율은 동일하지만 두 번째 결과가 Sampling에 따른 불확실성은 더 작습니다.
따라서 실험결과나 연구자료를 읽을 때는 결과의 백분율뿐 아니라 몇 번의 Shot에서 얻어진 결과인지 확인하는 것이 좋습니다.
회로 실행 횟수가 중요한 이유를 한 번에 정리하면
| 이유 | 핵심 내용 |
|---|---|
| 확률분포 추정 | 한 번 측정으로는 전체 확률을 알 수 없음 |
| 통계적 안정성 | Shots 증가 시 Sampling Noise 감소 |
| 얽힘·상관관계 분석 | 반복 결과를 통해 비트열 사이의 관계 확인 |
| 기대값 계산 | 측정결과 평균으로 관측량 추정 |
| 희귀 상태 탐색 | 낮은 확률 결과를 관찰하려면 더 많은 샘플 필요 |
| 변분 알고리즘 | 비용함수·기대값을 반복적으로 추정해야 함 |
| 정확도와 비용 | Shots 증가에는 QPU 시간과 계산비용이 따름 |
오해와 실제 의미
| 오해 | 실제 의미 |
|---|---|
| 양자회로는 한 번 실행하면 답이 나온다 | 한 Shot에서는 측정결과 하나만 얻으며 확률 추정에는 반복이 필요하다 |
| Shots가 두 배면 오차가 절반이 된다 | 통계오차는 보통 1/√N 정도로 감소한다 |
| Shots를 많이 사용하면 모든 오류가 없어진다 | 주로 Sampling Noise가 줄어들며 체계적 하드웨어 오류는 별도 문제다 |
| 관측되지 않은 상태는 확률이 0이다 | 확률이 작아 현재 Shot에서 나오지 않았을 수도 있다 |
| Shots와 Circuit Depth는 같은 의미다 | Shots는 반복 횟수이고 Depth는 한 회로의 연산 깊이다 |
| 상태벡터 시뮬레이터도 항상 수많은 Shots가 필요하다 | 이상적인 상태벡터 자체를 계산할 수 있는 시뮬레이션도 있다 |
| 가장 많은 Shots가 항상 가장 효율적이다 | 필요한 정밀도와 실행비용 사이의 균형이 중요하다 |
직접 생각해보면 좋은 6가지 예제
- |+⟩를 10번, 100번, 10,000번 측정했을 때 예상되는 결과 차이를 생각해보기
- p=0.5에서 100 Shots와 10,000 Shots의 표준오차를 직접 계산해보기
- 통계오차를 절반으로 줄이려면 Shot 수를 몇 배 늘려야 하는지 계산해보기
- 1,000 Shots에서 한 번도 나오지 않은 상태를 확률 0이라고 할 수 있는지 생각해보기
- 게이트 오류가 있는 회로에서 Shots만 계속 늘리면 어떤 분포로 수렴할지 생각해보기
- VQE에서 파라미터 100개를 평가하고 각 평가에 5,000 Shots를 사용한다면 전체 회로 실행 횟수를 계산해보기
회로 실행 횟수 이해 점검 체크리스트
- 하나의 Shot이 무엇을 의미하는지 설명할 수 있는가
- 왜 한 번의 측정만으로 양자상태의 확률분포를 알 수 없는지 이해했는가
- Counts를 이용해 측정확률을 추정할 수 있는가
- Shot 수가 많아질수록 Sampling Noise가 감소하는 이유를 알고 있는가
- 통계적 오차가 대략 1/√N으로 감소한다는 점을 이해했는가
- Shots를 4배 늘리면 통계오차가 대략 절반이 된다는 점을 설명할 수 있는가
- 많은 Shots가 하드웨어 오류를 자동으로 제거하지 않는다는 점을 알고 있는가
- 희귀 결과에는 더 많은 Shot이 필요할 수 있음을 이해했는가
- Shots와 Circuit Depth·Gate Count를 구분할 수 있는가
- 양자 알고리즘에서 필요한 정확도와 실행비용을 함께 고려해야 함을 이해했는가
자주 묻는 질문
Shot은 정확히 무엇인가요?
일반적으로 동일한 양자회로를 준비하고 실행한 뒤 측정결과를 얻는 한 번의 반복을 의미합니다. 여러 Shot을 수행하면 여러 개의 측정 비트열을 얻고 이를 이용해 확률이나 기대값을 추정할 수 있습니다.
왜 양자컴퓨터는 한 번 계산하고 끝내지 않나요?
한 번의 측정에서는 하나의 고전적인 결과만 얻기 때문입니다. 중첩 상태가 가진 측정확률이나 여러 큐비트의 상관관계를 알아내려면 같은 회로를 반복 실행해 통계를 수집해야 합니다.
Shots는 많을수록 정확한가요?
Sampling으로 인한 통계적 불확실성은 일반적으로 Shot 수가 증가할수록 감소합니다. 하지만 게이트 오류나 측정 편향과 같은 체계적인 하드웨어 오류까지 자동으로 사라지는 것은 아닙니다.
1,000 Shots면 충분한가요?
문제에 따라 다릅니다. 큰 확률 차이를 확인하는 용도라면 충분할 수도 있지만 매우 작은 확률 차이를 구분하거나 희귀 결과를 찾고 정밀한 기대값을 계산하려면 더 많은 Shot이 필요할 수 있습니다.
왜 Shots를 100배 늘려도 오차는 100분의 1이 되지 않나요?
일반적인 독립 표본의 통계적 표준오차가 Shot 수 N의 제곱근에 반비례하기 때문입니다. 따라서 Shot을 100배 늘리면 통계적 오차는 대략 10분의 1 수준으로 줄어듭니다.
시뮬레이터에서는 Shots가 필요 없나요?
상태벡터 자체를 계산하는 이상적인 시뮬레이션에서는 확률진폭을 직접 얻을 수 있어 Sampling이 반드시 필요한 것은 아닙니다. 하지만 실제 하드웨어와 같은 측정과정을 모방하거나 측정 통계를 실험하려면 시뮬레이터에서도 repetitions 또는 shots를 사용합니다.
같은 회로인데 왜 Shot마다 결과가 달라지나요?
양자상태가 여러 측정결과에 대해 확률을 가질 수 있기 때문입니다. 동일한 상태와 동일한 회로를 준비하더라도 측정에서는 해당 확률분포에 따라 서로 다른 결과가 나타날 수 있습니다.
마지막 핵심정리
양자컴퓨팅에서 회로 실행 횟수가 중요한 가장 기본적인 이유는 한 번의 측정으로 양자상태 전체를 확인할 수 없기 때문입니다. 하나의 Shot에서는 가능한 측정결과 가운데 하나의 비트열만 얻게 됩니다.
같은 회로를 여러 번 실행하면 각 결과가 나온 횟수를 이용해 측정확률을 추정할 수 있습니다. Shot 수가 많아질수록 일반적으로 표본에 따른 통계적 변동은 줄어들고 실제 확률분포나 기대값을 더 안정적으로 추정할 수 있습니다.
하지만 반복 횟수를 늘리는 효과에는 한계가 있습니다. 통계적인 표준오차는 대략 1/√N에 비례하기 때문에 정확도를 두 배 높이기 위해서는 약 네 배의 Shot이 필요할 수 있습니다. 정밀도를 높일수록 필요한 QPU 실행량이 빠르게 증가하는 이유입니다.
또한 Shots를 늘리는 것과 하드웨어 오류를 줄이는 것은 서로 다른 문제입니다. 측정장치나 게이트에 일정한 편향이 있다면 많은 Shot은 그 편향된 분포를 더 정확하게 보여줄 뿐 이상적인 정답으로 자동 보정해주지는 않습니다.
특히 VQE와 같은 하이브리드 알고리즘에서는 하나의 기대값을 얻기 위해 많은 Shot을 사용하고 이 과정을 파라미터를 바꾸어 다시 반복하기 때문에 Shot 수가 전체 계산시간과 자원 사용량을 크게 좌우할 수 있습니다.
결국 중요한 것은 가능한 한 많은 Shot을 사용하는 것이 아니라 해결하려는 문제에서 필요한 신뢰도와 정밀도를 확보할 수 있는 만큼의 Shot을 효율적으로 배분하는 것입니다. 양자회로의 실행 횟수는 단순한 반복 숫자가 아니라 결과의 신뢰성과 계산비용을 연결하는 핵심 변수라고 볼 수 있습니다.
참고문헌
- IBM Quantum Learning, Build and Run Your First Quantum Program
- IBM Quantum Learning, Variational Algorithm Design – Cost Functions
- IBM Quantum Documentation, Estimator Inputs and Outputs
- IBM Quantum Documentation, Estimator Options
- Google Quantum AI, Introduction to Cirq
- Google Quantum AI, Cirq Basics
- Google Quantum AI, Best Practices