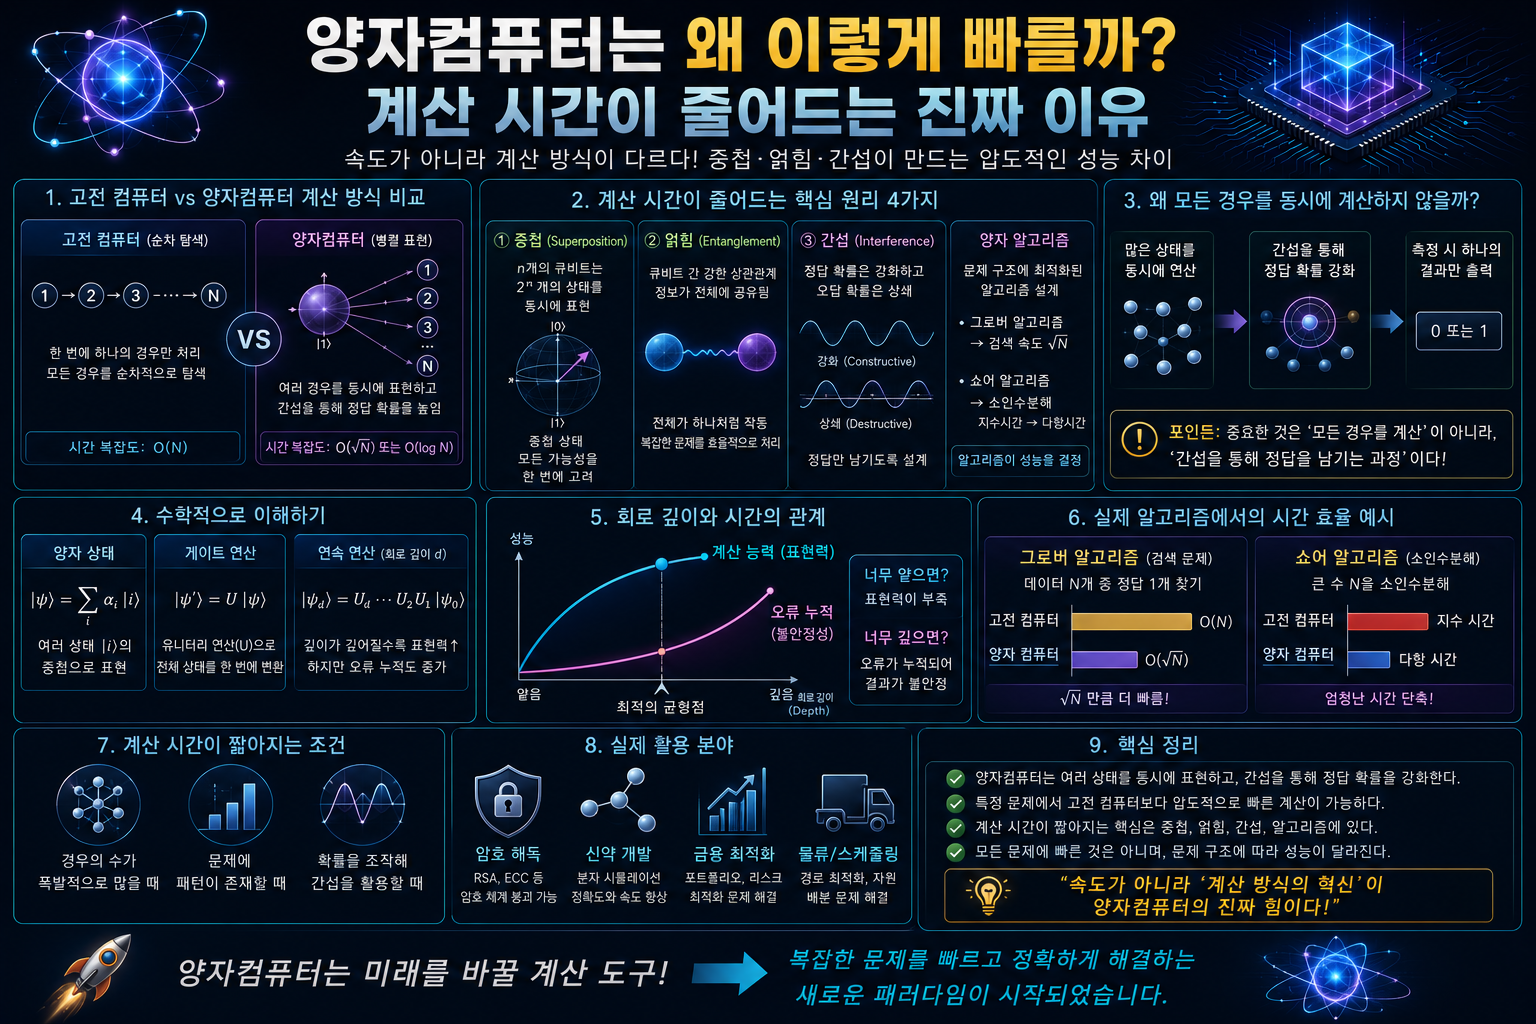
양자컴퓨터가 모든 문제를 더 빨리 푸는 것은 아닙니다. 속도 향상은 문제의 구조에 맞는 양자 알고리즘을 설계했을 때 기대할 수 있습니다. 이 글은 정렬되지 않은 항목에서 정답 하나를 찾는 문제를 예로 들어, ‘빠르다’가 정확히 무엇을 뜻하는지 설명합니다.
속도를 비교하려면 문제와 기준부터 정한다
찾을 곳이 N개이고 어느 항목이 정답인지 확인하는 함수만 있다고 가정해 봅시다. 순서나 색인 같은 구조가 없으므로 고전적인 탐색은 최악의 경우 N번, 평균적으로 대략 N/2번 확인합니다. 그로버 알고리즘은 이 확인 함수(오라클)를 부르는 횟수를 대략 √N에 비례하도록 줄입니다. 이는 모든 프로그램의 실행 시간이 √N으로 줄어든다는 뜻이 아닙니다.
1만 개 항목을 찾는 사고 실험
N=10,000이고 정답이 하나인 경우 고전적인 무작위 순차 확인은 평균 약 5,000회, 최악 10,000회가 필요합니다. 이상적인 그로버 모델에서는 대략 π√N/4 ≈ 79회의 오라클 호출로 높은 성공 확률을 얻습니다. 이 수치는 직접 기기에서 측정한 실행 시간이 아니라 이론적인 질의 횟수 비교입니다. 오라클 회로 제작, 오류, 반복 측정, 입출력 비용을 포함한 실제 소요 시간은 별도 평가가 필요합니다.
중첩만으로 속도가 나오지 않는 이유
여러 후보의 확률진폭을 가진 상태를 준비해도 측정하면 한 번에 한 결과만 나옵니다. 그로버 알고리즘은 정답 후보에 위상 표시를 하고 간섭을 반복하여 그 후보를 측정할 확률을 높입니다. 어떤 간섭을 어떻게 설계하느냐가 핵심이지 모든 답을 한꺼번에 읽어내는 방식이 아닙니다. 중첩과 측정의 차이는 ‘동시에 계산한다’는 표현의 한계에서 한 큐비트 예제로 확인할 수 있습니다.
어떤 결론까지 말할 수 있을까
그로버 사례는 정렬되지 않은 탐색에서의 이차적인 질의 복잡도 향상을 보여 줍니다. 정렬된 데이터베이스 검색, 모든 최적화 문제, 신약 설계가 자동으로 빨라진다는 근거가 되지는 않습니다. 문제마다 고전 알고리즘과 비교 기준을 다시 정해야 하며, 현재 하드웨어에서 실용적인 우위를 얻는지는 회로 깊이와 오류 비용을 함께 따져야 합니다.
같은 ‘검색’이라도 조건이 바뀌면 비교가 달라진다
정렬된 목록에서는 고전 컴퓨터도 이진 탐색으로 약 log₂N번의 비교에 답을 찾을 수 있습니다. 그로버의 N 대 √N 비교는 정렬이나 색인 등 활용할 구조가 없고, 답을 확인하는 함수만 주어진 상황을 전제로 합니다. 실제 검색 서비스의 색인 조회 시간을 그로버의 질의 횟수와 그대로 비교하면 다른 문제를 한 표에 섞는 셈입니다.
정답 표시 함수가 복잡하거나 여러 정답이 있으면 회로 설계와 필요한 반복 횟수도 달라집니다. 예를 들어 1만 후보의 ‘79회’는 정답이 하나라는 이상적 조건에서의 근삿값입니다. 고전적 5천 회와 양자적 79회를 CPU 초와 QPU 초로 해석하지 말고, 같은 오라클을 호출하는 알고리즘 모델의 비용으로 읽어야 합니다.
근거: IBM Quantum Learning, Grover’s algorithm은 비교 대상, O(N)과 O(√N)의 질의 수, 정답 진폭 증폭 과정 및 구현 조건을 설명합니다. 이 글의 숫자는 해당 설명을 N=10,000에 대입한 계산 예시입니다.