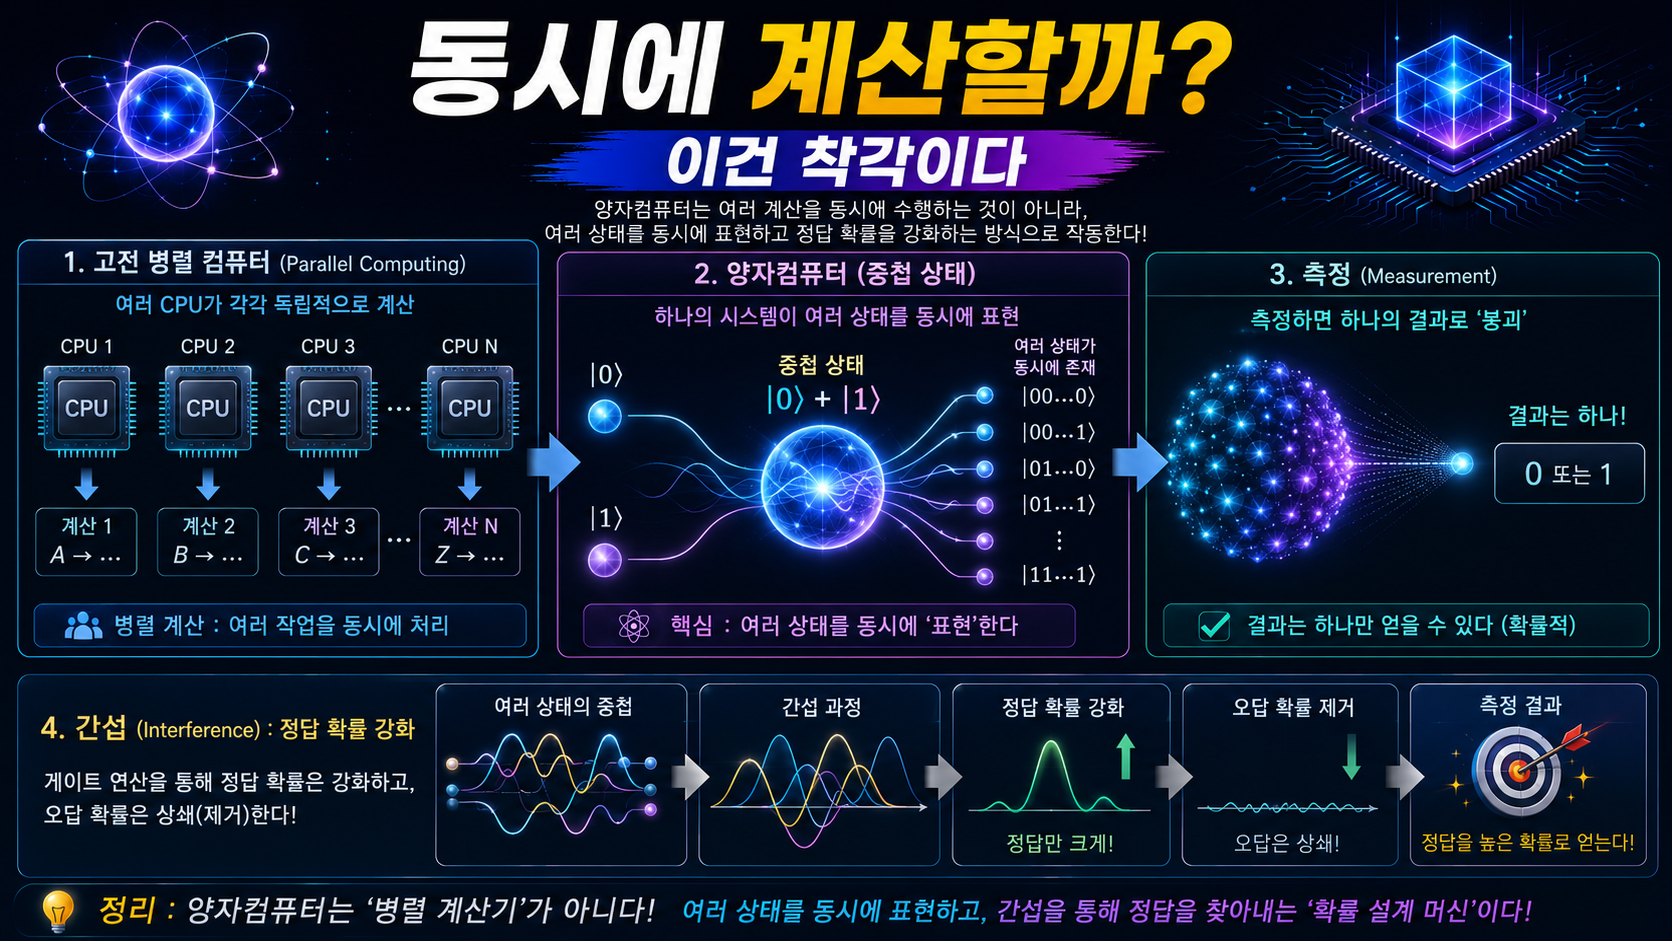
‘양자컴퓨터가 모든 경우를 동시에 계산한다’는 말에는 설명할 점이 있습니다. 양자 게이트는 중첩된 입력의 각 성분에 선형적으로 작용하지만, 마지막 측정에서 그 모든 성분의 답을 각각 읽을 수는 없습니다. 병렬 연산이라는 말의 의미를 상태 변화, 간섭, 출력으로 나눠 보겠습니다.
한 큐비트에 H 게이트를 두 번 적용하기
처음 상태가 |0⟩일 때 아다마르(H) 게이트를 한 번 적용하면 (|0⟩+|1⟩)/√2가 됩니다. 지금 바로 측정하면 0과 1이 각각 50% 확률로 나옵니다. 두 번째 H를 적용하면 H|0⟩=(|0⟩+|1⟩)/√2와 H|1⟩=(|0⟩−|1⟩)/√2의 부호가 간섭하여 다시 |0⟩가 됩니다. 이때 측정 결과는 이상적인 회로에서 0입니다. 두 번째 연산을 생략했을 때와의 차이가 간섭이 결과를 바꾸는 모습입니다.
양자 병렬성과 여러 결과의 동시 출력은 다르다
n개의 큐비트 상태는 2ⁿ개의 기저 상태에 대한 확률진폭으로 기술할 수 있습니다. 연산은 이 성분들에 영향을 주므로 ‘양자 병렬성’이라는 표현도 문맥에 따라 쓰입니다. 그러나 3큐비트에 8개의 성분이 있다고 해서 측정 한 번으로 8개의 고전적 답을 모두 얻지는 않습니다. 알고리즘은 위상과 간섭을 설계해 필요한 정보가 측정될 확률을 높이거나 다른 방식으로 답을 추출해야 합니다.
검색 예시와 이 글의 경계
정렬되지 않은 항목에서 답 하나를 찾는 그로버 알고리즘은 후보의 진폭을 조절해 정답을 찾을 확률을 높입니다. 왜 빨라질 수 있는가에서는 고전적 탐색의 O(N)과 그로버의 O(√N)을 오라클 질의 수라는 공통 기준으로 비교합니다. 이 글은 속도 수치보다는 ‘동시 계산’이라는 표현을 해석하는 데 초점을 맞춥니다.
직접 확인할 때 유의할 점
시뮬레이터에서 H를 한 번 적용한 회로와 두 번 적용한 회로를 각각 여러 번 실행하고 측정 분포를 비교할 수 있습니다. 실제 장치에서는 잡음 때문에 두 번째 회로도 0만 나오지 않을 수 있습니다. 여기의 게이트 계산은 수식으로 설명한 예제이며, 이 글에서 별도의 실기기 측정을 수행한 것은 아닙니다.
위상과 확률을 구별하는 간단한 확인
H|0⟩와 H|1⟩는 둘 다 측정만 하면 0과 1이 각각 절반의 확률로 나타납니다. 하지만 첫 번째는 (|0⟩+|1⟩)/√2이고 두 번째는 (|0⟩−|1⟩)/√2입니다. 측정 분포가 같아도 두 상태의 상대적인 부호, 즉 위상은 다릅니다. 다시 H를 적용하면 첫 상태는 |0⟩, 둘째 상태는 |1⟩로 돌아가므로 그 차이가 관찰됩니다. 단순히 ‘확률을 마음대로 조작한다’는 말보다, 게이트가 위상과 진폭을 바꾸어 간섭을 만든다고 설명하는 편이 정확합니다.
2큐비트에 H를 각각 적용하면 네 기저상태에 진폭이 분포합니다. 그래도 측정 한 번의 출력은 00, 01, 10, 11 중 하나입니다. 여러 번 실행한 측정 분포를 보고 회로의 특성을 추정할 수 있지만, 측정 한 번으로 네 개의 독립된 함수값을 출력한 것은 아닙니다. 예제의 자세한 상태 표현은 비트와 큐비트 비교에서 확인하세요.
근거: IBM Quantum Learning, Superposition with Qiskit 및 Grover’s algorithm의 H 게이트와 진폭 증폭 설명을 참고했습니다.