
양자컴퓨팅에서 큐비트의 증가는 표현가능한 부분의 확장성에 영향을 줬는데요. 이 배열구조는 연결 방식에 따라 실제 회로 성능에 영향을 미칩니다. 이번 글에서는 큐비트의 배열 구조와 구조별 특징에 대해 함께 알아보도록 하시죠.
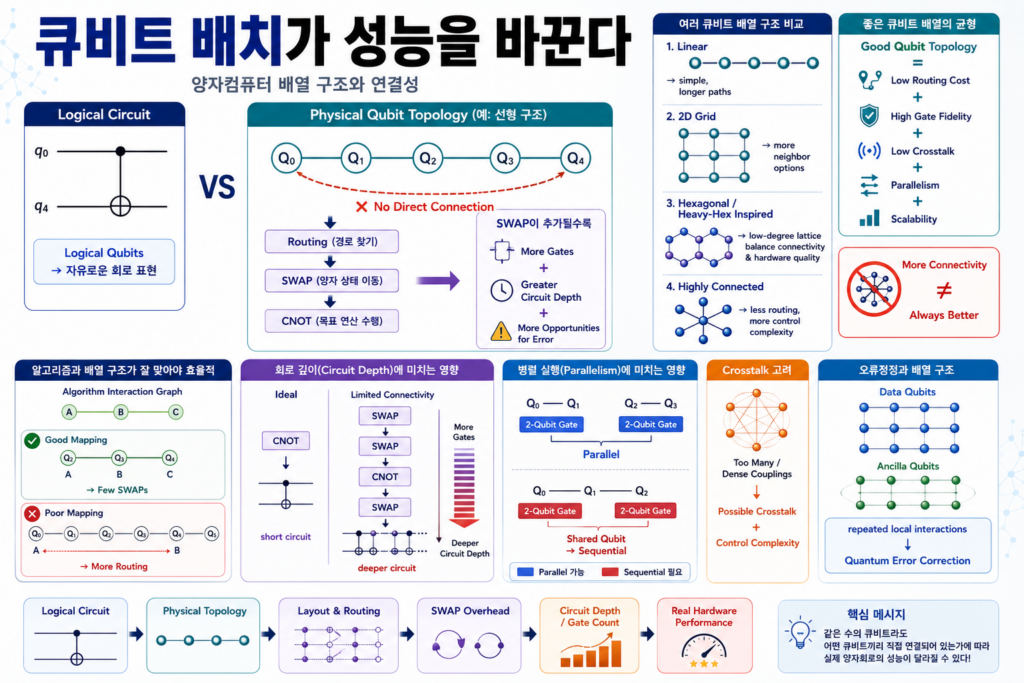
큐비트 배열 구조가 왜 양자컴퓨터 성능에 중요할까
양자컴퓨터의 성능을 이야기할 때 가장 먼저 눈에 들어오는 숫자는 큐비트 수입니다. 하지만 실제 양자회로를 실행할 때는 큐비트가 몇 개인지만큼이나 어떤 큐비트끼리 직접 연결되어 있는지가 중요합니다.
양자 알고리즘에서는 CNOT이나 CZ처럼 두 큐비트가 함께 참여하는 연산이 자주 사용됩니다. 문제는 실제 양자 하드웨어에서 임의의 두 큐비트가 항상 직접 2큐비트 게이트를 수행할 수 있는 것은 아니라는 점입니다.
어떤 큐비트가 서로 직접 상호작용할 수 있는지를 나타내는 구조를 연결성 또는 토폴로지라고 합니다. IBM Quantum에서는 이를 coupling map이라는 그래프로 표현하며, Google Quantum AI의 하드웨어 역시 실제 장치에서 연결된 큐비트 쌍을 기준으로 2큐비트 연산 가능 여부를 정의합니다.
따라서 같은 100개의 큐비트를 가지고 있더라도 연결구조가 어떻게 설계되어 있는지에 따라 필요한 SWAP 게이트 수, 회로 깊이, 오류 누적과 병렬 실행 능력이 달라질 수 있습니다.
| 배열 구조가 영향을 주는 요소 | 성능에 미치는 영향 |
|---|---|
| 직접 연결 가능한 큐비트 수 | 2큐비트 게이트를 바로 실행할 수 있는 범위 결정 |
| 큐비트 사이 거리 | 멀수록 Routing·SWAP 비용이 증가할 수 있음 |
| 연결 밀도 | 회로 배치의 자유도와 하드웨어 복잡성에 영향 |
| 병렬 가능한 연결 | 한 번에 실행할 수 있는 2큐비트 연산 수에 영향 |
| 크로스토크 | 인접한 연산이 다른 큐비트에 오류를 유발할 가능성 |
| 오류정정 호환성 | 특정 QEC 코드 구현에 필요한 상호작용 구조 결정 |
큐비트 배열은 그래프로 생각하면 이해하기 쉽다
큐비트 배열 구조를 이해하는 가장 쉬운 방법은 그래프로 생각하는 것입니다.
각 큐비트를 하나의 점, 즉 노드로 두고 직접 2큐비트 게이트를 수행할 수 있는 큐비트 사이를 선으로 연결합니다.
Qubit
→ Node

Direct Two-Qubit Interaction
→ Edge


Q0 ─ Q1 ─ Q2
     │
     Q3
이 그래프가 바로 양자 프로세서의 연결구조를 보여주는 기본적인 형태입니다.
Q0과 Q1이 연결되어 있다면 해당 하드웨어가 지원하는 2큐비트 게이트를 직접 수행할 수 있습니다. 반면 Q0과 Q2가 직접 연결되어 있지 않다면 중간 큐비트를 거쳐 양자정보를 이동시키는 과정이 필요할 수 있습니다.
논리적 양자회로와 실제 하드웨어는 다르다
교재나 양자 프로그래밍 단계에서는 원하는 두 큐비트 사이에 자유롭게 CNOT을 그릴 수 있습니다.
Logical Circuit

q0 ─────●────
        │
q4 ─────X────
하지만 실제 프로세서가 다음과 같은 선형 연결구조라고 생각해 보겠습니다.
Physical Qubits

Q0 ─ Q1 ─ Q2 ─ Q3 ─ Q4
Q0과 Q4는 직접 연결되어 있지 않습니다. 따라서 논리적인 q0과 q4를 그대로 Q0과 Q4에 배치했다면 CNOT을 직접 실행할 수 없습니다.
이 문제를 해결하기 위해 양자컴파일러는 논리 큐비트를 적절한 물리 큐비트에 배치하거나, 필요한 경우 SWAP 연산을 삽입해 양자정보를 직접 연결된 위치로 이동시킵니다.
SWAP 게이트가 왜 성능에 영향을 줄까
SWAP은 두 큐비트의 양자상태를 서로 교환하는 연산입니다.
Before

Q0 = |ψA⟩
Q1 = |ψB⟩

   ↓ SWAP

After

Q0 = |ψB⟩
Q1 = |ψA⟩
문제는 SWAP 역시 공짜 연산이 아니라는 점입니다. 실제 회로에서는 여러 기본 2큐비트 게이트로 분해해야 할 수 있기 때문에 추가적인 게이트와 실행시간이 필요합니다.
따라서 원래 알고리즘에는 없던 SWAP이 많이 추가되면 회로 깊이가 증가하고 오류가 발생할 기회도 많아집니다.
Poor Mapping / Limited Connectivity

↓

More Routing

↓

More SWAP Gates

↓

More Two-Qubit Operations

↓

Greater Circuit Depth

↓

Potentially More Error
가까운 큐비트를 사용하면 왜 유리할까
양자 알고리즘에서 자주 상호작용하는 논리 큐비트들을 실제 하드웨어에서도 서로 가까운 위치에 배치하면 필요한 이동을 줄일 수 있습니다.
예를 들어 A와 B가 계속 CNOT을 수행하고 B와 C 역시 자주 상호작용한다면 세 큐비트를 실제 프로세서에서도 서로 가까운 위치에 배치하는 것이 유리할 수 있습니다.
Algorithm Interaction

A ─ B ─ C


Good Physical Mapping

Q2 ─ Q3 ─ Q4


Poor Physical Mapping

Q1 ─ Q2 ─ Q3 ─ Q4 ─ Q5 ─ Q6
 ↑                         ↑
 A                         B
이 때문에 양자컴파일 과정에서는 단순히 사용 가능한 큐비트를 아무 위치에 배치하는 것이 아니라 회로의 상호작용 패턴과 하드웨어 연결구조를 함께 고려합니다.
Layout과 Routing은 무엇이 다를까
양자회로를 실제 하드웨어에 맞추는 과정에서 Layout과 Routing이라는 용어가 자주 등장합니다.
| 구분 | 역할 |
|---|---|
| Layout | 논리 큐비트를 실제 물리 큐비트에 배치 |
| Routing | 연결되지 않은 큐비트의 상호작용이 가능하도록 경로 조정 |
| SWAP 삽입 | Routing 과정에서 양자정보 위치를 이동할 때 사용 |
| Optimization | 불필요한 게이트와 회로 깊이를 줄이도록 최적화 |
좋은 Layout은 이후 필요한 Routing을 줄여줍니다. 반대로 배치를 잘못 선택하면 같은 알고리즘이라도 훨씬 많은 SWAP이 필요할 수 있습니다.
대표적인 큐비트 배열 구조를 비교해보자
양자 하드웨어의 큐비트 배열은 물리적 구현 방식과 설계목표에 따라 달라질 수 있습니다. 개념적으로는 다음과 같은 구조를 생각해볼 수 있습니다.
| 배열 형태 | 특징 | 장점 | 주의할 점 |
|---|---|---|---|
| 선형 | 양옆 큐비트와 연결 | 구조가 단순 | 멀리 있는 큐비트 사이 Routing 증가 가능 |
| 2차원 격자 | 상하좌우 인접 큐비트 연결 | 2차원 문제와 오류정정 구조에 활용 가능 | 모든 큐비트가 직접 연결되지는 않음 |
| 육각형 계열 | 낮은 연결도를 가진 격자 구조 | 하드웨어 오류와 연결성 사이 균형 가능 | 일부 알고리즘에서 추가 Routing 필요 |
| 고연결 구조 | 한 큐비트가 많은 다른 큐비트와 연결 | Routing 부담 감소 가능 | 제어 복잡성·크로스토크 등 고려 필요 |
어느 하나가 모든 양자컴퓨터에 항상 최적이라고 말할 수는 없습니다. 사용하는 큐비트 기술과 목표 알고리즘, 오류정정 방식에 따라 필요한 연결구조가 달라지기 때문입니다.
선형 배열은 어떤 특징이 있을까
선형 배열은 큐비트를 한 줄로 배치하고 주로 인접한 큐비트끼리 연결하는 단순한 구조입니다.
Q0 ─ Q1 ─ Q2 ─ Q3 ─ Q4
이 구조에서는 가까운 큐비트 사이의 연산은 단순하지만 양 끝에 있는 Q0과 Q4가 직접 상호작용해야 한다면 여러 단계의 이동이 필요할 수 있습니다.
따라서 상호작용이 대부분 이웃 사이에서 발생하는 알고리즘에는 비교적 적합할 수 있지만 멀리 떨어진 큐비트가 빈번하게 상호작용하는 회로에서는 Routing 부담이 커질 수 있습니다.
2차원 격자 구조는 무엇이 다를까
2차원 격자에서는 한 줄 구조보다 다양한 방향으로 인접한 큐비트와 연결할 수 있습니다.
Q0 ─ Q1 ─ Q2
│    │    │
Q3 ─ Q4 ─ Q5
│    │    │
Q6 ─ Q7 ─ Q8
선형 구조보다 평균적인 이동거리를 줄일 가능성이 있고 여러 위치에서 동시에 2큐비트 연산을 수행할 수 있는 여지도 커집니다.
Google Quantum AI의 장치 문서에서도 실제 큐비트가 격자 형태로 배치되고 수평 또는 수직으로 인접한 큐비트 사이에서 연결이 제한되는 구조가 설명됩니다.
Heavy-Hex 구조는 왜 연결을 일부러 줄였을까
연결이 많을수록 Routing에 유리하다면 모든 큐비트를 최대한 많이 연결하면 좋을 것 같지만 실제 하드웨어에서는 그렇게 단순하지 않습니다.
IBM은 초전도 큐비트 시스템에서 연결성이 증가할수록 해결해야 할 주파수 조건이 많아지고 frequency collision과 spectator error 같은 문제가 커질 수 있다는 점을 고려해 heavy-hex 구조를 도입했습니다.
Heavy-Hex는 이전보다 연결도를 일부 낮추는 대신 이러한 하드웨어 오류를 줄이고 제조와 확장 측면의 균형을 추구한 구조입니다.
More Connectivity

장점
→ shorter routing

하지만

→ more hardware constraints
→ possible frequency collisions
→ possible spectator interactions


Lower / Optimized Connectivity

→ more routing may be needed
→ but hardware error can decrease
즉 양자컴퓨터의 배열 설계는 ‘연결이 많을수록 좋다’는 단순한 문제가 아니라 소프트웨어의 Routing 비용과 실제 하드웨어 오류 사이의 절충 문제입니다.
연결성이 높으면 항상 좋은 것은 아니다
하나의 큐비트가 여러 큐비트와 직접 연결되어 있으면 논리적인 회로를 실제 하드웨어에 배치하기가 쉬워지고 SWAP을 줄일 가능성이 있습니다.
하지만 물리적으로 많은 연결을 구현하려면 추가적인 제어와 결합구조가 필요할 수 있으며 원하지 않는 상호작용이나 크로스토크를 관리하는 문제도 커질 수 있습니다.
| 연결성이 높을 때 | 연결성이 낮을 때 |
|---|---|
| Routing·SWAP 감소 가능 | 하드웨어 연결구조가 단순해질 수 있음 |
| 회로 배치의 자유도 증가 | 원하지 않는 상호작용을 줄일 가능성 |
| 멀리 있는 큐비트의 직접 연산 가능성 증가 | 주파수·제어 조건을 단순화할 수 있음 |
| 물리적 제어 복잡성이 증가할 수 있음 | 일부 회로의 Routing 비용이 증가할 수 있음 |
따라서 좋은 양자 프로세서의 토폴로지는 무조건 최대 연결을 추구하기보다 해당 하드웨어에서 가장 좋은 전체 성능을 얻는 방향으로 설계됩니다.
큐비트 배열은 회로 깊이에 어떤 영향을 줄까
회로 깊이는 양자회로를 실행하는 데 필요한 순차적인 연산 단계의 수를 이해할 때 사용하는 개념입니다.
원래 알고리즘에서는 한 단계면 되는 2큐비트 연산이라도 두 큐비트가 멀리 떨어져 있다면 여러 SWAP과 원래 게이트를 순차적으로 실행해야 할 수 있습니다.
Ideal Logical Circuit

CNOT
↓
1 interaction


Hardware with Limited Connectivity

SWAP
↓
SWAP
↓
CNOT
↓
SWAP ...

→ deeper circuit
회로가 길어질수록 큐비트가 노이즈에 노출되는 시간과 실행되는 게이트 수도 증가할 수 있기 때문에 실제 결과의 정확도에도 영향을 줄 수 있습니다.
배열 구조는 2큐비트 게이트 수에도 영향을 준다
양자 하드웨어에서는 일반적으로 2큐비트 연산이 회로 오류에서 중요한 부분을 차지합니다.
Routing을 위해 추가되는 SWAP 역시 여러 2큐비트 연산으로 구현될 수 있기 때문에 배열구조가 알고리즘에 잘 맞지 않으면 원래 회로보다 훨씬 많은 2큐비트 게이트가 필요해질 수 있습니다.
Algorithm

20 Two-Qubit Gates

↓

Poor Topology Match

+ Routing / SWAP

↓

More Physical
Two-Qubit Gates
따라서 컴파일된 회로를 평가할 때는 원래 알고리즘의 게이트 수뿐 아니라 실제 하드웨어에 매핑한 뒤 얼마나 많은 추가 게이트가 생겼는지도 살펴보는 것이 중요합니다.
병렬 실행 능력도 배열구조의 영향을 받는다
전체 게이트 수가 같더라도 여러 게이트를 동시에 실행할 수 있다면 회로 실행시간을 줄일 수 있습니다.
예를 들어 서로 큐비트를 공유하지 않는 연결에서 수행되는 2큐비트 게이트는 동시에 실행할 가능성이 있습니다.
Q0 ─ Q1     Q2 ─ Q3

Gate A      Gate B

→ no shared qubit
→ parallel execution possible


Q0 ─ Q1 ─ Q2

Q0-Q1 gate
Q1-Q2 gate

→ Q1 shared
→ cannot use Q1 in both
   at the same time
IBM의 heavy-hex 기반 교육자료에서는 연결선을 서로 큐비트를 공유하지 않는 세 개의 그룹으로 나눠 전체 장치에 필요한 2큐비트 상호작용을 세 번의 연속적인 라운드로 수행하는 예도 설명합니다.
따라서 토폴로지는 단순히 ‘연결되어 있는가’뿐 아니라 어떤 게이트들을 동시에 실행할 수 있는가에도 영향을 줍니다.
큐비트 배열과 크로스토크는 어떤 관계가 있을까
크로스토크는 한 큐비트나 게이트를 제어할 때 의도하지 않은 영향이 다른 큐비트나 연산에 나타나는 현상을 의미합니다.
큐비트가 많아지고 서로 복잡하게 연결될수록 이런 원하지 않는 상호작용을 관리하는 문제가 중요해질 수 있습니다.
그래서 실제 하드웨어 설계에서는 높은 연결성으로 얻는 소프트웨어상의 이점과 낮은 크로스토크·높은 게이트 충실도로 얻는 하드웨어상의 이점을 함께 고려해야 합니다.
알고리즘과 배열구조가 잘 맞으면 성능이 좋아질 수 있다
모든 양자 알고리즘이 모든 큐비트 사이의 상호작용을 똑같이 요구하는 것은 아닙니다.
어떤 알고리즘은 가까운 이웃끼리 반복적으로 상호작용하고, 어떤 회로는 멀리 떨어진 논리 큐비트 사이의 연산이 자주 필요합니다.
Problem Interaction Graph

        ↓ compare

Hardware Coupling Graph

        ↓

Good Match

→ fewer SWAPs
→ shallower circuit


Poor Match

→ more routing
→ deeper circuit
따라서 특정 알고리즘을 효율적으로 실행하려면 문제의 상호작용 구조와 하드웨어 토폴로지가 얼마나 잘 맞는지를 살펴볼 필요가 있습니다.
양자 시뮬레이션에서는 배열 구조가 특히 직관적으로 보인다
물리계의 양자 시뮬레이션에서는 서로 가까운 입자나 스핀 사이의 상호작용을 양자회로로 표현하는 경우가 많습니다.
시뮬레이션하려는 문제의 상호작용 그래프와 실제 양자 프로세서의 연결구조가 비슷하다면 필요한 추가 이동을 줄일 수 있습니다.
반대로 문제에서는 두 변수가 직접 상호작용해야 하지만 실제 하드웨어에서는 멀리 떨어져 있다면 그 상호작용을 구현하기 위해 추가 회로가 필요합니다.
오류정정에서도 배열구조가 중요한 이유
큐비트 토폴로지는 현재의 NISQ 회로뿐 아니라 미래의 오류정정형 양자컴퓨터에서도 중요한 요소입니다.
양자 오류정정 코드는 데이터 큐비트와 보조 큐비트 사이에 특정한 형태의 반복적인 상호작용을 요구합니다.
Data Qubits

D ─ D ─ D
│   │   │
A ─ A ─ A
│   │   │
D ─ D ─ D

A = Ancilla
따라서 어떤 오류정정 코드를 사용할 것인지와 실제 큐비트 배열을 어떻게 설계할 것인지는 서로 독립적인 문제가 아닙니다.
실제 연구에서도 하드웨어 연결구조에 맞도록 오류정정 코드를 설계하거나 특정 코드를 효율적으로 구현할 수 있는 하드웨어 구조를 함께 연구하는 co-design이 중요하게 다뤄집니다.
배열구조는 큐비트 수와 별개의 성능 지표다
예를 들어 두 양자 프로세서가 모두 100개의 큐비트를 가지고 있다고 생각해 보겠습니다.
| 항목 | Processor A | Processor B |
|---|---|---|
| 큐비트 수 | 100 | 100 |
| 연결구조 | 알고리즘과 비교적 잘 맞음 | 많은 Routing 필요 |
| 추가 SWAP | 적음 | 많음 |
| 컴파일 후 회로 깊이 | 상대적으로 짧음 | 상대적으로 길 수 있음 |
| 실제 결과 품질 | 게이트 품질에 따라 유리할 수 있음 | 추가 게이트로 불리해질 수 있음 |
즉 큐비트 숫자가 같다고 해서 실제로 실행할 수 있는 회로의 품질까지 같은 것은 아닙니다.
연결도 Degree는 무엇을 의미할까
그래프에서 하나의 노드가 몇 개의 다른 노드와 직접 연결되어 있는지를 Degree라고 합니다.
     Q1
      │
Q2 ─ Q0 ─ Q3
      │
     Q4

Degree of Q0 = 4
큐비트의 평균 Degree가 높으면 더 많은 큐비트와 직접 2큐비트 연산을 할 수 있기 때문에 Routing 측면에서는 유리할 가능성이 있습니다.
하지만 Degree를 무조건 높이는 것이 전체 하드웨어 성능을 최대화한다는 의미는 아닙니다. 실제 구현에서는 연결마다 추가적인 하드웨어 조건과 오류 가능성을 고려해야 하기 때문입니다.
큐비트 사이의 평균 거리도 중요하다
두 큐비트가 직접 연결되지 않았을 때 몇 개의 연결을 거쳐야 서로 만날 수 있는지도 중요한 요소입니다.
Q0 ─ Q1 ─ Q2 ─ Q3 ─ Q4

Q0 → Q4

Shortest Path Length = 4
일반적으로 서로 자주 상호작용해야 하는 큐비트 사이의 경로가 짧을수록 Routing 부담을 줄이기 쉽습니다.
그래서 양자컴파일에서는 단순히 전체 평균 연결성만 보는 것이 아니라 실제 회로에서 필요한 큐비트 쌍을 얼마나 가까운 위치에 매핑할 수 있는지가 중요합니다.
같은 하드웨어에서도 큐비트 선택에 따라 결과가 달라질 수 있다
실제 양자 프로세서의 모든 큐비트와 연결이 완전히 동일한 품질을 갖는 것은 아닐 수 있습니다.
Google Quantum AI 역시 실제 게이트의 오류와 특성이 큐비트와 장치에 따라 달라지고 시간에 따라 변할 수 있다고 설명합니다.
따라서 회로를 배치할 때는 토폴로지만 볼 것이 아니라 어떤 큐비트와 어떤 연결의 품질이 더 좋은지도 함께 고려할 수 있습니다.
Best Mapping

≠

Shortest Distance Only


Need to Consider

Connectivity
+
Gate Error
+
Readout Quality
+
Circuit Structure
큐비트 배열과 회로 최적화는 서로 연결되어 있다
양자 프로그래머가 작성한 회로는 실제 장치에 그대로 실행되는 것이 아니라 하드웨어에서 지원하는 형태로 변환됩니다.
Abstract Quantum Circuit

↓

Gate Decomposition

↓

Layout

↓

Routing

↓

Hardware Native Gates

↓

Optimization

↓

Executable Circuit
이 과정에서 배열구조를 잘 활용하면 추가되는 SWAP을 줄이고 일부 게이트를 취소하거나 더 효율적인 경로를 찾을 수 있습니다.
따라서 양자컴퓨터의 성능은 하드웨어 토폴로지와 컴파일러의 최적화 능력을 함께 봐야 합니다.
배열 구조가 성능에 미치는 영향을 한 번에 정리하면
| 배열 특성 | 직접적인 영향 | 최종적으로 영향을 받는 요소 |
|---|---|---|
| 직접 연결 수 | 가능한 2큐비트 연산 범위 | Routing 비용 |
| 평균 경로 길이 | 멀리 있는 큐비트 이동량 | SWAP 수 |
| 연결구조와 문제의 적합성 | 논리 회로 매핑 효율 | 게이트 수·회로 깊이 |
| 독립적인 연결 수 | 동시 2큐비트 연산 가능성 | 병렬성·실행시간 |
| 연결 밀도 | Routing 자유도 | 하드웨어 복잡성·오류와 절충 |
| 물리적 배치 | 크로스토크와 제어조건 | 게이트 품질 |
| 오류정정 친화성 | syndrome 회로 구현 난이도 | 논리 큐비트 성능 |
그렇다면 가장 좋은 큐비트 배열은 무엇일까
모든 양자컴퓨터에 공통으로 적용할 수 있는 하나의 정답은 없습니다.
모든 큐비트를 서로 직접 연결하면 소프트웨어 측면에서는 편리해 보이지만 실제 하드웨어에서는 구현 복잡성과 크로스토크, 제어문제가 커질 수 있습니다.
반대로 연결을 지나치게 줄이면 하드웨어는 단순해질 수 있지만 많은 알고리즘에서 Routing과 SWAP이 증가할 수 있습니다.
Good Qubit Topology

≠ Maximum Connectivity

Good Qubit Topology

= Balance between

Routing Cost
+
Gate Fidelity
+
Crosstalk
+
Parallelism
+
Scalability
+
Error Correction
결국 좋은 배열은 해당 큐비트 기술과 목표 알고리즘에서 전체 계산성능을 가장 높일 수 있는 균형점을 찾는 문제입니다.
입문자가 자주 하는 오해
| 오해 | 실제 의미 |
|---|---|
| 큐비트가 같은 수라면 성능도 비슷하다 | 연결성·오류·게이트 품질에 따라 크게 달라질 수 있다 |
| 양자회로에서 원하는 두 큐비트에 CNOT을 바로 실행할 수 있다 | 실제 하드웨어 연결구조의 제약을 받는다 |
| 연결되지 않은 큐비트는 함께 계산할 수 없다 | Routing과 SWAP을 이용해 상호작용을 구현할 수 있다 |
| SWAP은 단순히 위치만 바꾸므로 비용이 없다 | 실제 회로에서는 추가 게이트와 실행시간이 필요하다 |
| 연결성이 높을수록 무조건 좋다 | 크로스토크·제어 복잡성·하드웨어 오류와 절충이 필요하다 |
| 배열 구조는 하드웨어 엔지니어만 알면 된다 | 회로 배치와 최적화에도 직접 영향을 준다 |
| 토폴로지는 회로의 결과와 무관하다 | 추가 게이트와 오류를 통해 실제 실행 품질에 영향을 줄 수 있다 |
큐비트 배열 구조를 공부하는 추천 순서
| 단계 | 학습 내용 | 확인할 핵심 |
|---|---|---|
| 1단계 | 다중 큐비트 | CNOT·CZ의 역할 |
| 2단계 | Connectivity | 직접 상호작용 가능한 큐비트 |
| 3단계 | Coupling Map | 큐비트 연결 그래프 |
| 4단계 | Layout | 논리→물리 큐비트 배치 |
| 5단계 | SWAP | 양자정보 위치 이동 |
| 6단계 | Routing | 연결 제약 해결 |
| 7단계 | Circuit Depth | 추가 게이트가 회로에 미치는 영향 |
| 8단계 | Crosstalk | 하드웨어 연결성의 비용 |
| 9단계 | Topology-aware Compilation | 알고리즘과 하드웨어 매칭 |
| 10단계 | Quantum Error Correction | 토폴로지와 QEC의 관계 |
직접 생각해보면 좋은 세 가지 예제
- 선형으로 연결된 Q0-Q1-Q2-Q3에서 Q0과 Q3가 CNOT을 수행하려면 어떤 이동이 필요한지 생각해보기
- 같은 6개의 큐비트를 선형과 2차원 격자로 배치했을 때 평균 이동거리가 어떻게 달라질지 비교해보기
- 알고리즘의 상호작용 그래프와 하드웨어 coupling map이 완전히 같다면 Routing이 얼마나 단순해질지 생각해보기
큐비트 배열 구조 이해 점검 체크리스트
- 큐비트 배열 구조와 연결성이 무엇을 의미하는지 설명할 수 있는가
- Coupling Map에서 노드와 연결선이 무엇을 의미하는지 알고 있는가
- 논리 큐비트와 물리 큐비트의 차이를 설명할 수 있는가
- 직접 연결되지 않은 큐비트 사이에 Routing이 필요한 이유를 이해했는가
- SWAP이 증가하면 회로 깊이와 게이트 수가 늘어날 수 있음을 알고 있는가
- 알고리즘과 하드웨어 토폴로지가 잘 맞으면 Routing 비용을 줄일 수 있음을 이해했는가
- 연결성이 높다고 항상 더 좋은 하드웨어가 되는 것은 아니라는 점을 알고 있는가
- 크로스토크와 spectator error가 배열 설계와 관계될 수 있음을 이해했는가
- 배열구조가 병렬 실행 가능성에도 영향을 준다는 점을 설명할 수 있는가
- 오류정정 코드와 하드웨어 토폴로지를 함께 설계할 필요가 있음을 이해했는가
자주 묻는 질문
큐비트는 모두 서로 직접 연결되어 있지 않나요?
그렇지 않은 경우가 많습니다. 실제 양자 하드웨어에서는 물리적으로 직접 2큐비트 게이트를 수행할 수 있는 큐비트 쌍이 정해져 있을 수 있으며 이를 coupling map이나 connectivity graph로 표현합니다.
연결되지 않은 큐비트끼리는 CNOT을 할 수 없나요?
논리적으로는 구현할 수 있습니다. 다만 직접 연결되어 있지 않다면 컴파일 과정에서 SWAP 등의 연산을 추가해 양자정보를 연결 가능한 위치로 이동시키는 Routing 과정이 필요할 수 있습니다.
SWAP이 많으면 왜 좋지 않은가요?
SWAP도 실제 하드웨어에서는 추가적인 양자 게이트로 구현해야 하기 때문입니다. SWAP이 많아지면 전체 게이트 수와 회로 깊이가 증가하고, 실제 노이즈가 있는 하드웨어에서는 오류가 누적될 가능성도 커질 수 있습니다.
모든 큐비트를 서로 연결하면 가장 좋은 것 아닌가요?
소프트웨어의 Routing 측면에서는 유리할 수 있지만 실제 하드웨어에서는 많은 연결을 구현하고 제어하는 과정에서 크로스토크나 주파수 충돌, 제어 복잡성 등의 문제가 생길 수 있습니다. 따라서 실제 설계에서는 연결성과 하드웨어 품질 사이의 균형을 고려합니다.
양자 알고리즘도 하드웨어 배열을 고려해서 만들어야 하나요?
이론적으로는 하드웨어와 독립적인 회로를 만들 수 있지만 실제 장치에서 효율적으로 실행하려면 토폴로지를 고려하는 것이 유리할 수 있습니다. 하드웨어 연결구조와 잘 맞는 회로는 Routing과 추가 게이트를 줄일 가능성이 있기 때문입니다.
Heavy-Hex가 모든 배열보다 좋은 구조인가요?
그렇게 일반화할 수는 없습니다. Heavy-Hex는 특정 초전도 큐비트 하드웨어에서 오류와 연결성, 확장성을 함께 고려해 개발된 구조입니다. 다른 큐비트 구현이나 다른 목표에서는 다른 토폴로지가 더 적합할 수 있습니다.
핵심 용어와 마무리 정리
| 용어 | 의미 |
|---|---|
| Qubit Topology | 큐비트가 물리적으로 어떤 구조로 연결되어 있는지를 나타내는 배열 |
| Connectivity | 어떤 큐비트 쌍이 직접 상호작용할 수 있는지를 나타내는 연결성 |
| Coupling Map | 물리 큐비트와 가능한 2큐비트 상호작용을 그래프로 나타낸 구조 |
| Layout | 논리 큐비트를 실제 물리 큐비트에 대응시키는 과정 |
| Routing | 하드웨어 연결 제약을 만족하도록 큐비트의 위치와 상호작용 경로를 조정하는 과정 |
| SWAP | 두 큐비트가 가진 양자상태를 서로 교환하는 연산 |
| Circuit Depth | 회로에서 순차적으로 실행해야 하는 연산 단계의 깊이 |
| Crosstalk | 특정 큐비트의 제어나 연산이 다른 큐비트에 의도치 않은 영향을 미치는 현상 |
| Degree | 하나의 큐비트가 직접 연결된 다른 큐비트의 수 |
| Heavy-Hex | 낮은 연결도와 하드웨어 오류 사이의 균형을 고려한 육각형 계열 토폴로지 |
양자컴퓨터의 큐비트 배열 구조가 중요한 이유는 실제 양자회로의 2큐비트 연산이 하드웨어의 물리적 연결성에 영향을 받기 때문입니다. 원하는 큐비트가 직접 연결되어 있다면 게이트를 바로 수행할 수 있지만 그렇지 않다면 Routing과 SWAP 같은 추가 과정이 필요할 수 있습니다.
추가된 SWAP은 회로의 게이트 수와 깊이를 증가시킬 수 있고 실제 노이즈가 존재하는 하드웨어에서는 최종 결과의 품질에도 영향을 줄 수 있습니다. 따라서 같은 수의 큐비트를 가진 프로세서라도 배열과 연결구조가 다르면 실제 회로 성능이 달라질 수 있습니다.
그렇다고 연결성이 높은 구조가 항상 가장 좋은 것도 아닙니다. 물리적으로 많은 큐비트를 서로 연결하려면 제어구조가 복잡해지고 원하지 않는 상호작용이나 크로스토크를 관리해야 할 수 있습니다. Heavy-Hex처럼 일부 하드웨어는 오히려 연결도를 조절해 이러한 오류를 줄이는 방향을 선택하기도 합니다.
결국 좋은 큐비트 배열은 최대한 많은 연결을 만드는 구조가 아니라 필요한 알고리즘을 적은 Routing 비용으로 실행하면서도 높은 게이트 품질과 낮은 크로스토크, 충분한 병렬성과 확장성을 확보할 수 있는 구조라고 볼 수 있습니다.
양자컴퓨터의 성능을 비교할 때 큐비트 개수만 보는 것보다 어떤 큐비트끼리 직접 연결되어 있는지, 실제 회로를 매핑했을 때 SWAP이 얼마나 추가되는지, 그리고 그 연결에서 얼마나 정확한 2큐비트 연산을 수행할 수 있는지를 함께 살펴보는 것이 중요합니다.
참고문헌
큐비트 배열 구조와 연결성, Layout·Routing 및 실제 하드웨어 토폴로지에 관한 내용은 아래 공식 자료를 참고해 정리했습니다.
- IBM Quantum Documentation, Represent Quantum Computers for the Transpiler
- IBM Quantum Documentation, Introduction to Transpilation
- IBM Quantum, The IBM Quantum Heavy-Hex Lattice
- IBM Quantum Learning, Simulating Nature
- Google Quantum AI, Google Devices
- Google Quantum AI, Cirq Devices
- Google Quantum AI, Qubit Placement
- Google Quantum AI, Best Practices for Quantum Hardware