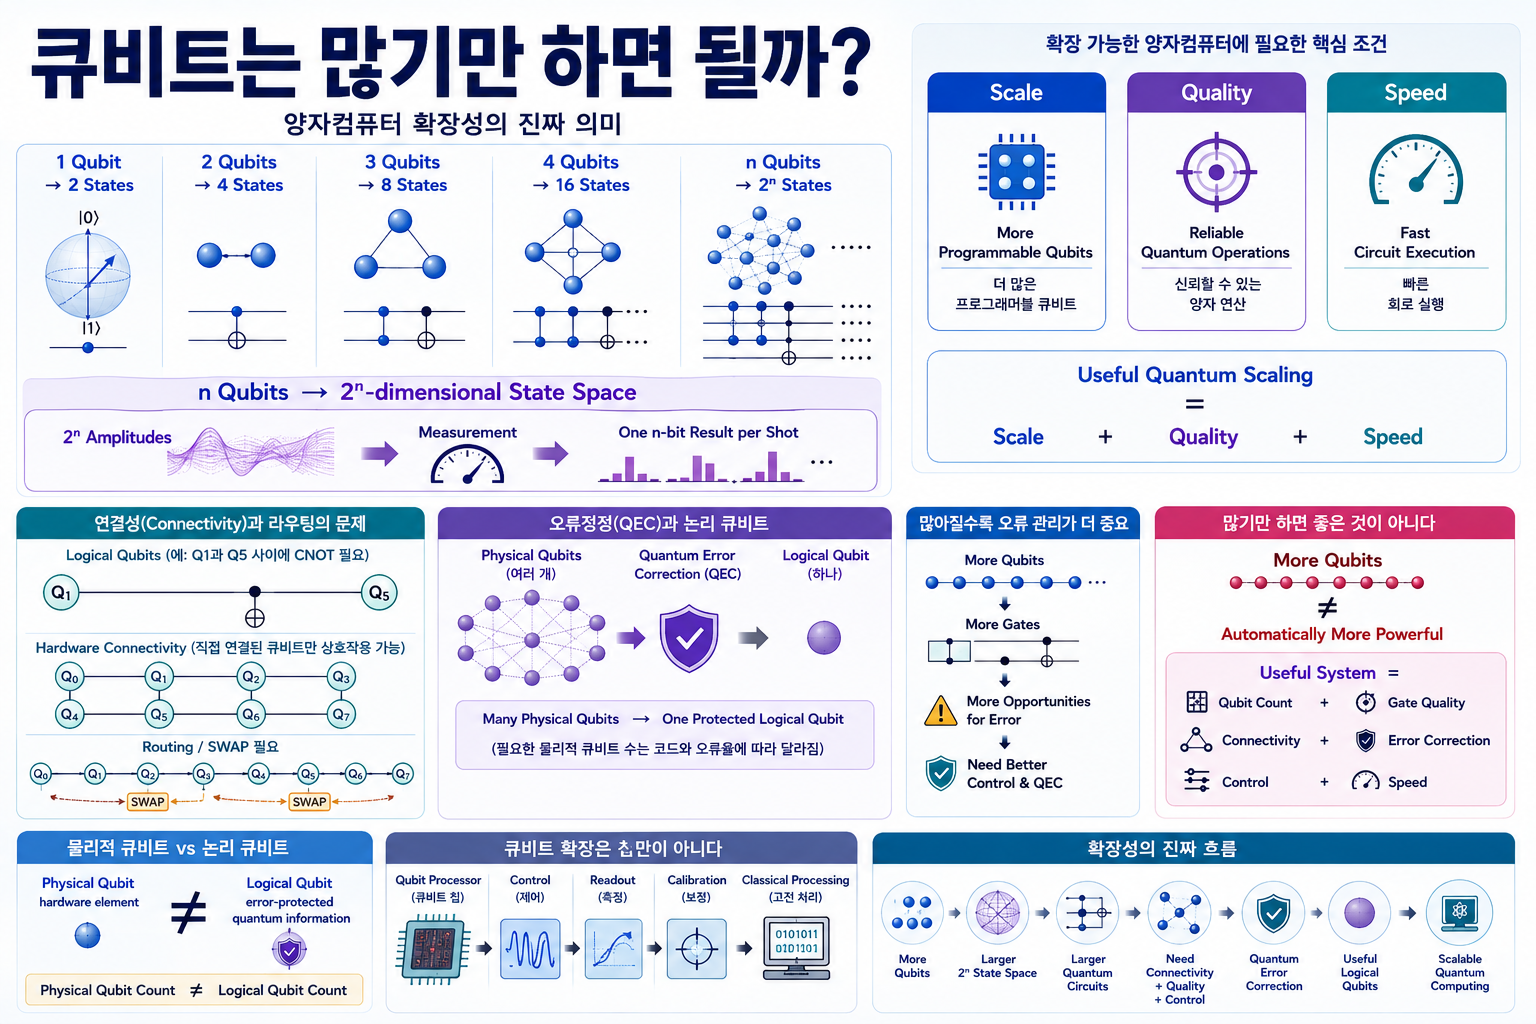
양자컴퓨팅에서 큐비트가 뭐길래 계속 확장성에 대한 얘기가 나오는 걸까요? 큐비트가 증가하면 표현할 수 있는 상태공간이 빠르게 커지게 되는데요. 사실 이것만 늘려서는 좋은 양자컴퓨터가 된다고 할 수 없습니다. 이번 글에서는 큐비트의 확장성에 대해 다룹니다.

양자컴퓨팅에서 큐비트 확장성이 중요한 이유
양자컴퓨터의 발전을 이야기할 때 가장 먼저 등장하는 숫자 가운데 하나가 큐비트 수입니다. 몇 개의 큐비트를 사용하는지에 따라 다룰 수 있는 양자상태의 크기가 달라지기 때문입니다.
한 큐비트는 |0⟩과 |1⟩이라는 두 개의 계산 기저 상태를 가지고, 두 큐비트는 |00⟩·|01⟩·|10⟩·|11⟩이라는 네 개의 계산 기저 상태를 가집니다.
이 구조는 큐비트가 하나씩 추가될 때마다 빠르게 커집니다.
1 qubit
→ 2 basis states

2 qubits
→ 4 basis states

3 qubits
→ 8 basis states

10 qubits
→ 1,024 basis states

n qubits
→ 2ⁿ basis states
이 때문에 큐비트 확장성은 더 큰 양자상태와 더 복잡한 문제를 다루기 위한 기본 조건입니다.
하지만 여기서 주의해야 할 점이 있습니다. 큐비트 수가 많다는 사실만으로 양자컴퓨터의 성능이 결정되지는 않습니다. 큐비트의 품질, 서로 연결되는 방식, 게이트 오류, 계산속도와 오류정정 능력까지 함께 확장되어야 실제 계산에 사용할 수 있습니다.
| 확장 요소 | 왜 중요한가 |
|---|---|
| 큐비트 수 | 더 큰 양자 상태공간을 구성 |
| 큐비트 품질 | 긴 계산 동안 상태와 연산 정확도 유지 |
| 연결성 | 필요한 큐비트 사이의 다중 큐비트 연산 수행 |
| 게이트 성능 | 오류 누적을 줄이고 더 깊은 회로 실행 |
| 제어·측정 | 늘어난 큐비트를 동시에 정확하게 운용 |
| 오류정정 | 신뢰할 수 있는 논리 큐비트 구현 |
| 실행속도 | 실용적인 시간 안에 충분한 계산 수행 |
큐비트가 늘어나면 상태공간은 어떻게 커질까
한 큐비트의 일반적인 순수 상태는 다음과 같이 표현할 수 있습니다.
|ψ⟩ =
α|0⟩ + β|1⟩
두 큐비트가 되면 네 개의 계산 기저 상태가 필요합니다.
|ψ⟩ =

α|00⟩
+
β|01⟩
+
γ|10⟩
+
δ|11⟩
세 큐비트에서는 여덟 개의 계산 기저 상태가 등장합니다.
|000⟩
|001⟩
|010⟩
|011⟩
|100⟩
|101⟩
|110⟩
|111⟩
따라서 n개의 큐비트로 이루어진 일반적인 순수 상태에는 최대 2ⁿ개의 계산 기저 상태에 대응하는 복소수 확률진폭이 존재할 수 있습니다.
큐비트 하나를 추가하면 왜 상태공간이 두 배가 될까
각 큐비트의 상태공간이 2차원이기 때문입니다. 여러 큐비트를 하나의 시스템으로 결합할 때는 상태공간의 텐서곱을 사용합니다.
1 qubit

2 dimensions


2 qubits

2 × 2
=
4 dimensions


3 qubits

2 × 2 × 2
=
8 dimensions


n qubits

2ⁿ dimensions
그래서 큐비트를 하나 추가할 때마다 일반적인 상태벡터를 표현하는 데 필요한 성분의 수가 두 배가 됩니다.
| 큐비트 수 | 상태공간 차원 |
|---|---|
| 1 | 2 |
| 5 | 32 |
| 10 | 1,024 |
| 20 | 1,048,576 |
| 30 | 1,073,741,824 |
| n | 2ⁿ |
그렇다면 큐비트가 늘어나면 계산속도도 지수적으로 빨라질까
그렇지는 않습니다. 2ⁿ차원의 상태공간을 가진다는 사실과 모든 문제를 2ⁿ배 빠르게 해결한다는 것은 서로 다른 이야기입니다.
양자컴퓨터는 2ⁿ개의 계산 기저 상태에 확률진폭을 가질 수 있지만 한 번의 측정에서 2ⁿ개의 값을 모두 읽어낼 수 있는 것은 아닙니다.
n-Qubit Quantum State

2ⁿ amplitudes

        ↓

Measurement

        ↓

one n-bit result per shot
양자 알고리즘은 거대한 상태공간을 만든 뒤 끝나는 것이 아니라 확률진폭과 위상을 정교하게 조절하고 간섭시켜 원하는 답이 측정될 가능성을 높여야 합니다.
따라서 큐비트 수가 증가하면 사용할 수 있는 상태공간이 커지는 것은 맞지만 실제 속도향상은 알고리즘의 구조에 따라 달라집니다.
확장성이 중요한 첫 번째 이유는 더 큰 문제를 표현하기 위해서다
양자 알고리즘에서도 문제의 규모가 커지면 더 많은 양자정보를 표현해야 합니다.
예를 들어 정수의 비트 수가 증가하거나 더 많은 변수, 더 큰 분자, 더 복잡한 양자계 등을 계산하려면 그 상태를 표현할 수 있는 충분한 큐비트가 필요합니다.
Small Problem
↓
few qubits

Larger Problem
↓
more qubits

Large-Scale Application
↓
large logical quantum register
즉 큐비트 확장성은 단순히 컴퓨터의 숫자를 키우는 것이 아니라 양자컴퓨터가 처리할 수 있는 문제의 크기를 확대하기 위한 조건입니다.
두 번째 이유는 더 복잡한 얽힘 구조를 만들기 위해서다
큐비트가 여러 개가 되면 단일 큐비트에서는 존재하지 않았던 얽힘과 다중 큐비트 상관관계를 만들 수 있습니다.
두 큐비트에서는 대표적으로 Bell 상태를 만들 수 있습니다.
|Φ+⟩ =

1/√2(
|00⟩ + |11⟩
)
세 큐비트 이상으로 확장되면 훨씬 다양한 다중 큐비트 상관관계와 얽힘 구조를 구성할 수 있습니다.
양자 알고리즘에서 항상 최대한 많은 얽힘이 필요한 것은 아니지만, 여러 큐비트의 공동 상태와 상관관계를 원하는 방식으로 만들어낼 수 있는 능력은 범용적인 양자계산에서 중요합니다.
하지만 큐비트 수만 늘려서는 부족하다
100개의 품질이 낮은 큐비트와 100개의 높은 품질을 가진 큐비트를 단순히 같은 수준의 시스템이라고 평가하기는 어렵습니다.
양자회로에서는 게이트를 실행할 때마다 작은 오류가 발생할 수 있고 회로가 길어질수록 이러한 오류가 누적될 수 있기 때문입니다.
More Qubits

≠

Automatically Better Quantum Computer


Useful Scaling

=

More Qubits
+
Higher Quality
+
Enough Speed
+
Useful Connectivity
+
Error Management
따라서 실질적인 확장성은 큐비트 수뿐 아니라 큐비트가 얼마나 정확하고 안정적으로 동작하는지를 함께 포함하는 개념으로 보는 것이 좋습니다.
양자컴퓨터의 성능을 Scale·Quality·Speed로 보는 이유
현대 양자 하드웨어를 평가할 때는 큐비트 수만 보는 방식에서 점차 벗어나고 있습니다.
IBM Quantum은 하드웨어 성능을 이해할 때 규모(Scale), 품질(Quality), 속도(Speed)를 함께 살펴보는 관점을 제시합니다.
| 구분 | 의미 |
|---|---|
| Scale | 사용자가 실제 프로그램에서 이용할 수 있는 프로그래머블 큐비트의 규모 |
| Quality | 오류가 계산을 압도하기 전까지 신뢰성 있게 수행할 수 있는 연산 능력 |
| Speed | 유용한 양자회로를 얼마나 빠르게 처리할 수 있는가 |
즉 좋은 양자컴퓨터는 단순히 큐비트가 많아야 하는 것이 아니라 많은 큐비트에서 충분한 품질과 실행속도를 동시에 확보해야 합니다.
큐비트가 많아질수록 오류 문제도 커질 수 있다
양자상태는 주변 환경과의 상호작용과 제어오차에 민감합니다.
큐비트가 늘어나면 더 많은 큐비트를 준비하고 제어해야 하며 더 많은 단일·다중 큐비트 게이트를 사용할 가능성도 커집니다.
More Qubits

↓

More Operations

↓

More Opportunities for Error

↓

Need Better
Control + Calibration + QEC
따라서 큐비트를 늘리면서도 개별 큐비트와 게이트의 오류율을 충분히 낮게 유지하는 것이 중요한 기술과제가 됩니다.
다중 큐비트 게이트의 품질이 특히 중요한 이유
양자 알고리즘에서는 큐비트 사이의 상호작용을 만들기 위해 CNOT·CZ 등의 다중 큐비트 연산이 필요합니다.
단순히 많은 큐비트를 한 칩에 배치해 놓고 서로 정확하게 상호작용시키지 못한다면 큰 양자회로를 제대로 구현하기 어렵습니다.
Many Qubits

without useful interaction

↓

limited circuit capability


Many Qubits
+
reliable two-qubit operations

↓

complex multi-qubit circuits
확장 가능한 양자컴퓨터에서는 큐비트 수 증가와 다중 큐비트 게이트 품질을 함께 고려해야 합니다.
큐비트 연결성도 확장성의 일부다
양자회로에서는 임의의 두 논리 큐비트 사이에 CNOT을 그리고 싶을 수 있습니다.
하지만 실제 하드웨어에서는 모든 물리적 큐비트가 서로 직접 연결되어 있는 것은 아닐 수 있습니다.
Logical Circuit

Q0 ─────●────
        │
Q5 ─────X────


Physical Hardware

Q0 — Q1 — Q2 — Q3 — Q4 — Q5
직접 연결되지 않은 큐비트 사이에 상호작용이 필요하다면 회로 컴파일 과정에서 SWAP과 같은 추가 연산을 넣어 상태를 이동시키는 라우팅이 필요할 수 있습니다.
추가 게이트는 회로를 길게 만들고 오류가 발생할 기회를 늘릴 수 있습니다. 따라서 큐비트 수를 확장할 때 연결구조 역시 중요한 설계요소입니다.
큐비트가 많아질수록 회로 배치와 라우팅도 중요해진다
양자 프로그램에서 사용하는 논리적인 큐비트를 실제 프로세서의 물리적 큐비트에 대응시키는 과정을 Layout이라고 합니다.
필요한 큐비트 상호작용을 실제 하드웨어 연결구조에 맞도록 변환하는 과정은 Routing이라고 볼 수 있습니다.
Quantum Algorithm

↓

Logical Qubits

↓

Layout

↓

Physical Qubits

↓

Routing

↓

Hardware-Compatible Circuit
따라서 큰 시스템에서는 하드웨어 자체의 확장뿐 아니라 회로를 효율적으로 배치하고 변환하는 소프트웨어 기술 역시 중요합니다.
물리적 큐비트와 논리 큐비트를 구분해야 한다
양자컴퓨팅의 확장성을 이해하려면 물리적 큐비트와 논리 큐비트를 구분해야 합니다.
물리적 큐비트는 실제 하드웨어에 구현된 개별 큐비트입니다.
반면 논리 큐비트는 여러 물리적 큐비트의 공동 상태를 이용해 양자정보를 오류로부터 보호하도록 인코딩한 큐비트입니다.
| 구분 | 물리적 큐비트 | 논리 큐비트 |
|---|---|---|
| 의미 | 실제 장치에 구현된 개별 큐비트 | 오류정정 코드로 보호된 정보 단위 |
| 오류 영향 | 직접 노출 | 여러 물리적 큐비트를 이용해 오류 억제 |
| 필요 개수 | 하드웨어 규모를 구성 | 하나를 만들기 위해 여러 물리적 큐비트가 필요할 수 있음 |
| 장기 목표 | 높은 품질과 대규모 구현 | 신뢰성 높은 내결함성 계산 |
왜 하나의 논리 큐비트에 여러 물리적 큐비트가 필요할까
양자정보는 단순히 같은 상태를 복사해 여러 곳에 저장할 수 없습니다. 대신 양자 오류정정 코드에서는 정보를 여러 물리적 큐비트의 공동 상태에 인코딩합니다.
Physical Qubits

Q1
Q2
Q3
...
Qn

     ↓
 Quantum Error
 Correction

Logical Qubit
일부 물리적 큐비트에 오류가 발생하더라도 syndrome 정보를 측정해 오류를 찾아내고 논리적 양자정보를 보호하는 것이 기본적인 아이디어입니다.
따라서 장기적으로 실용적인 양자컴퓨터를 만든다는 것은 단순히 많은 물리적 큐비트를 추가하는 문제가 아니라 충분히 많은 고품질 물리적 큐비트로 신뢰할 수 있는 논리 큐비트를 만드는 문제이기도 합니다.
오류정정 때문에 필요한 큐비트 수가 크게 늘어날 수 있다
오류정정을 적용하면 하나의 논리 큐비트를 만들기 위해 여러 개의 물리적 큐비트가 필요해집니다.
정확히 몇 개가 필요한지는 사용하는 큐비트의 오류율, 오류정정 코드, 요구되는 논리 오류율과 알고리즘 규모 등에 따라 달라집니다.
Algorithm

↓

Logical Qubits

↓

Quantum Error Correction

↓

Many Physical Qubits

↓

Physical Quantum Computer
따라서 미래의 대규모 양자컴퓨터에서는 알고리즘이 요구하는 논리 큐비트 수보다 실제 하드웨어의 물리적 큐비트 수가 훨씬 많아질 수 있습니다.
오류정정에도 확장성이 필요한 이유
오류정정은 한 번 적용하고 끝나는 기능이 아닙니다. 계산이 진행되는 동안 오류를 지속적으로 감지하고 관리해야 합니다.
이 과정에는 데이터 큐비트뿐 아니라 syndrome을 확인하기 위한 보조 큐비트, 측정, 다중 큐비트 게이트와 고전적인 처리까지 필요합니다.
Data Qubits

↓

Syndrome Extraction

↓

Ancilla Measurement

↓

Classical Processing

↓

Correction / Tracking

↓

Next QEC Cycle
따라서 큐비트의 수만 늘리는 것이 아니라 오류를 감지하고 처리하는 전체 시스템도 함께 커질 수 있어야 합니다.
내결함성 양자컴퓨팅은 무엇을 의미할까
오류정정 코드에 정보를 넣었다고 해서 모든 문제가 해결되는 것은 아닙니다.
오류를 수정하기 위해 사용하는 게이트와 측정 자체에도 오류가 발생할 수 있기 때문입니다.
그래서 오류가 발생하더라도 그 오류가 시스템 전체로 통제되지 않은 방식으로 퍼지는 것을 억제하면서 계산을 수행하는 내결함성 구조가 필요합니다.
Quantum Error Correction

+

Fault-Tolerant Gates

+

Fault-Tolerant Measurement

+

Controlled Error Propagation

=

Reliable Large-Scale Quantum Computing
즉 큐비트 확장의 최종 목표는 많은 큐비트를 보유하는 것보다 오류를 관리하면서 긴 계산을 실행할 수 있는 시스템을 만드는 데 있습니다.
큐비트 제어 시스템도 함께 확장되어야 한다
각 큐비트에는 상태 준비, 게이트 실행과 측정을 위한 제어가 필요합니다.
큐비트 수가 증가하면 더 많은 제어신호와 측정정보를 정확한 시간에 처리해야 하기 때문에 제어 시스템의 복잡성도 커집니다.
Few Qubits

↓
few control channels


Many Qubits

↓
many synchronized controls
+
readout
+
calibration
+
classical processing
따라서 양자컴퓨터의 확장성을 프로세서 칩의 큐비트 개수만으로 생각하면 실제 시스템이 해결해야 할 문제의 일부만 보는 셈입니다.
측정과 데이터 처리도 병목이 될 수 있다
양자컴퓨터는 최종적으로 큐비트를 측정해 고전적인 정보를 얻습니다.
큐비트와 회로 규모가 커지면 측정채널과 결과 처리량도 커지고, 반복 실행이 필요한 알고리즘에서는 많은 샷의 결과를 빠르게 처리해야 할 수도 있습니다.
Quantum Circuit

↓

Measurement

↓

Classical Bitstrings

↓

Aggregation

↓

Statistical Analysis

↓

Next Quantum / Classical Step
특히 변분 알고리즘과 같은 양자-고전 하이브리드 방식에서는 양자 프로세서와 고전 프로세서 사이의 반복적인 데이터 교환도 전체 실행시간에 영향을 줄 수 있습니다.
큐비트 수뿐 아니라 계산속도도 확장되어야 하는 이유
아무리 큰 회로를 실행할 수 있어도 한 번의 계산에 너무 오랜 시간이 걸린다면 실용성이 떨어질 수 있습니다.
따라서 많은 큐비트를 이용하면서도 회로를 충분히 빠르게 준비하고 실행하며 결과를 처리하는 능력이 필요합니다.
Useful Quantum Scaling

Scale
+
Quality
+
Speed
큐비트 수, 연산 신뢰성, 처리속도를 함께 향상시키는 것이 실용적인 양자컴퓨팅 확장의 핵심입니다.
고전 컴퓨터에서 양자상태를 시뮬레이션할 때도 확장성이 보인다
큐비트 상태공간이 2ⁿ으로 커진다는 특징은 고전 컴퓨터에서 양자회로를 상태벡터 방식으로 시뮬레이션할 때 매우 직관적으로 확인할 수 있습니다.
| 큐비트 수 | 저장해야 하는 일반적인 복소수 진폭 수 |
|---|---|
| 10 | 1,024 |
| 20 | 1,048,576 |
| 30 | 1,073,741,824 |
| 40 | 약 1.1조 |
상태벡터 방식에서는 큐비트가 하나 증가할 때마다 메모리에 보관해야 하는 일반적인 상태벡터 성분 수도 두 배가 됩니다.
다만 모든 양자회로가 동일한 방식으로 고전 시뮬레이션하기 어려운 것은 아닙니다. 상태의 구조와 얽힘 정도 등에 따라 텐서 네트워크 같은 다른 시뮬레이션 방법이 효과적인 경우도 있습니다.
큐비트 수가 많으면 무조건 좋은 시스템일까
큐비트 수는 분명 중요한 지표지만 하나의 숫자만으로 양자컴퓨터 전체 성능을 비교하기는 어렵습니다.
예를 들어 많은 큐비트가 있어도 게이트 오류가 크거나 연결성이 부족해 필요한 회로를 실행하기 어렵다면 실제로 이용 가능한 계산규모는 제한될 수 있습니다.
| 살펴볼 요소 | 질문 |
|---|---|
| 큐비트 수 | 몇 개의 큐비트를 실제 프로그램에서 사용할 수 있는가? |
| 게이트 품질 | 얼마나 정확하게 연산할 수 있는가? |
| 연결성 | 필요한 큐비트들이 효율적으로 상호작용할 수 있는가? |
| 회로 깊이 | 오류가 커지기 전에 얼마나 긴 계산을 수행할 수 있는가? |
| 측정 | 결과를 얼마나 정확하고 빠르게 읽을 수 있는가? |
| 오류정정 | 논리적인 양자정보를 얼마나 안정적으로 보호할 수 있는가? |
| 실행속도 | 필요한 회로를 충분한 처리량으로 실행할 수 있는가? |
물리적 큐비트 1,000개가 논리 큐비트 1,000개를 뜻하지 않는 이유
이 부분은 양자컴퓨팅의 규모를 볼 때 특히 중요합니다.
오류정정을 적용하는 시스템에서는 여러 물리적 큐비트를 하나의 논리 큐비트를 보호하는 데 사용할 수 있습니다.
Physical Qubit Count

≠

Logical Qubit Count
필요한 물리적 큐비트의 수는 오류정정 방식과 물리적 오류율, 원하는 신뢰성에 따라 달라집니다.
따라서 미래의 내결함성 양자컴퓨터를 비교할 때는 단순한 전체 물리적 큐비트 수뿐 아니라 실제 알고리즘이 사용할 수 있는 고품질 논리 큐비트가 얼마나 되는지도 중요해집니다.
양자 리소스 추정이 필요한 이유
어떤 알고리즘이 이론적으로 n개의 논리 큐비트를 필요로 한다고 해서 실제 하드웨어도 정확히 n개의 큐비트만 있으면 되는 것은 아닙니다.
실제 내결함성 시스템을 설계할 때는 오류정정과 게이트 구현에 필요한 추가 자원, 알고리즘 실행시간 등을 함께 계산해야 합니다.
Quantum Algorithm

↓

Logical Circuit

↓

Error Correction Requirements

↓

Physical Qubit Requirements
+
Runtime
+
Error Budget
이 때문에 대규모 양자컴퓨터를 설계할 때는 알고리즘 수준의 자원을 실제 물리적 자원으로 변환해보는 리소스 추정이 중요합니다.
큐비트와 실행시간 사이에도 절충이 생길 수 있다
양자컴퓨터를 설계할 때 항상 큐비트 수를 최소화하는 것이 정답은 아닙니다.
일부 설계에서는 더 많은 물리적 자원을 사용하면 계산을 더 빠르게 수행할 수 있고, 반대로 하드웨어 자원을 줄이는 대신 실행시간이 길어질 수도 있습니다.
Option A

More Qubits
+
Shorter Runtime


Option B

Fewer Qubits
+
Longer Runtime
따라서 실제 확장성은 단순히 큐비트를 최대한 많이 넣는 경쟁이라기보다 필요한 정확도와 실행시간을 만족하는 효율적인 시스템을 설계하는 문제에 가깝습니다.
확장 가능한 양자컴퓨터가 갖춰야 할 조건
- 문제 규모에 맞게 충분한 큐비트 수를 확보할 것
- 큐비트 수 증가에도 게이트 오류를 충분히 낮게 유지할 것
- 필요한 큐비트 사이에 효율적인 상호작용이 가능할 것
- 불필요한 SWAP과 회로 깊이를 줄일 수 있는 연결성을 확보할 것
- 많은 큐비트를 동시에 제어하고 측정할 수 있을 것
- 오류정정을 통해 신뢰성 높은 논리 큐비트를 구성할 수 있을 것
- 오류정정 과정에서도 오류의 확산을 제어할 수 있을 것
- 늘어난 회로를 실용적인 속도로 실행하고 결과를 처리할 수 있을 것
큐비트 확장성을 한 번에 정리하면
| 확장 단계 | 핵심 변화 | 새롭게 필요한 것 |
|---|---|---|
| 1 → n 큐비트 | 상태공간 2ⁿ차원으로 증가 | 더 큰 양자 레지스터 |
| 개별 → 다중 큐비트 | 얽힘·상관관계 가능 | 정확한 2큐비트 게이트 |
| 작은 → 큰 회로 | 오류 누적 증가 | 높은 게이트 품질 |
| 작은 → 큰 프로세서 | 연결구조 복잡화 | 효율적인 topology·routing |
| 물리적 → 논리적 큐비트 | 오류로부터 정보 보호 | QEC와 추가 물리적 큐비트 |
| 대규모 시스템 | 제어·측정 데이터 증가 | 제어전자·고전처리 확장 |
| 실용적 계산 | 많고 긴 회로 실행 | Scale·Quality·Speed의 동시 향상 |
입문자가 자주 하는 오해
| 오해 | 실제 의미 |
|---|---|
| 큐비트가 많을수록 무조건 좋은 양자컴퓨터다 | 품질·속도·연결성과 함께 봐야 한다 |
| n큐비트면 2ⁿ개의 답을 한 번에 읽을 수 있다 | 한 번의 측정에서는 하나의 n비트 결과를 얻는다 |
| 큐비트가 두 배면 계산속도도 두 배다 | 실제 속도향상은 알고리즘과 회로 구조에 따라 다르다 |
| 물리적 큐비트 수가 곧 사용 가능한 논리 큐비트 수다 | 오류정정에서는 여러 물리적 큐비트가 하나의 논리 큐비트를 구성할 수 있다 |
| 큐비트가 많으면 모두 자유롭게 연결할 수 있다 | 하드웨어의 물리적 연결구조에 제약이 있을 수 있다 |
| 오류정정은 소프트웨어만 추가하면 된다 | 추가 물리적 큐비트·연산·측정 등 하드웨어 자원이 필요하다 |
| 양자컴퓨터 확장은 칩 크기만 늘리면 된다 | 제어·측정·냉각·컴파일·오류정정까지 함께 확장해야 한다 |
큐비트 확장성을 공부하는 추천 순서
| 단계 | 학습 내용 | 확인할 핵심 |
|---|---|---|
| 1단계 | 단일 큐비트 | 2차원 상태공간 |
| 2단계 | 텐서곱 | 2ⁿ차원 상태공간 |
| 3단계 | 다중 큐비트 | 중첩·얽힘 |
| 4단계 | CNOT·CZ | 큐비트 상호작용 |
| 5단계 | Connectivity | 물리적 연결 제약 |
| 6단계 | Routing | SWAP과 회로 오버헤드 |
| 7단계 | Noise | 큐비트·게이트 오류 |
| 8단계 | QEC | 물리적·논리 큐비트 |
| 9단계 | Fault Tolerance | 오류 확산 제어 |
| 10단계 | Resource Estimation | 실제 물리 자원과 실행시간 계산 |
이해 점검 체크리스트
- n큐비트의 상태공간이 왜 2ⁿ차원인지 설명할 수 있는가
- 상태공간이 커지는 것과 계산속도가 지수적으로 빨라지는 것이 같은 의미가 아니라는 점을 이해했는가
- 큐비트 수 외에 게이트 품질과 실행속도가 중요한 이유를 설명할 수 있는가
- 다중 큐비트 게이트와 연결성이 확장성에 미치는 영향을 이해했는가
- 직접 연결되지 않은 큐비트 사이의 연산에 Routing과 SWAP이 필요할 수 있음을 알고 있는가
- 물리적 큐비트와 논리 큐비트를 구분할 수 있는가
- 하나의 논리 큐비트가 여러 물리적 큐비트를 필요로 할 수 있음을 이해했는가
- 오류정정도 추가 큐비트와 연산을 요구한다는 점을 알고 있는가
- 대규모 시스템에서는 제어·측정·고전처리도 함께 확장해야 한다는 점을 이해했는가
- Scale·Quality·Speed를 함께 보는 이유를 설명할 수 있는가
자주 묻는 질문
큐비트가 많으면 왜 좋은가요?
더 많은 큐비트를 사용하면 더 큰 양자 레지스터와 상태공간을 구성할 수 있기 때문에 더 큰 규모의 문제를 표현할 가능성이 생깁니다. 다만 실제 계산에 유용하려면 큐비트의 품질과 연결성도 충분해야 합니다.
100큐비트는 10큐비트보다 항상 더 좋은가요?
반드시 그렇지는 않습니다. 실제 활용 가능성은 큐비트 수뿐 아니라 게이트 오류율, 회로를 실행할 수 있는 깊이, 연결성, 측정 정확도와 실행속도 등에 따라 달라질 수 있습니다.
n큐비트가 2ⁿ개의 상태를 갖는다는 것은 2ⁿ개의 계산을 동시에 한다는 뜻인가요?
그렇게 단순하게 해석하면 안 됩니다. 양자상태에는 2ⁿ개의 계산 기저 상태에 대한 확률진폭이 존재할 수 있지만 측정에서는 하나의 결과를 얻게 됩니다. 양자 알고리즘은 간섭을 이용해 유용한 정보가 최종 측정결과에 나타나도록 설계합니다.
물리적 큐비트와 논리 큐비트 중 어느 숫자가 더 중요한가요?
목적에 따라 둘 다 중요합니다. 물리적 큐비트 수는 하드웨어의 기본 규모를 보여주지만 내결함성 계산에서는 오류정정을 거쳐 실제 프로그램에서 신뢰성 있게 사용할 수 있는 논리 큐비트의 규모가 특히 중요해집니다.
왜 오류정정을 하면 큐비트가 더 많이 필요한가요?
하나의 양자정보를 여러 물리적 큐비트의 공동 상태에 인코딩해 일부 큐비트에 발생한 오류를 감지하고 수정하기 때문입니다. 사용하는 오류정정 코드와 필요한 신뢰도에 따라 실제 필요한 물리적 자원은 달라집니다.
큐비트 확장성의 가장 큰 과제는 무엇인가요?
한 가지 문제로 정리하기는 어렵습니다. 많은 큐비트를 구현하면서도 낮은 오류율, 충분한 연결성, 정밀한 제어와 측정, 빠른 실행, 그리고 실용적인 오류정정을 동시에 확보해야 하기 때문입니다.
핵심 용어와 마무리 정리
| 용어 | 의미 |
|---|---|
| Scalability | 큐비트와 시스템 규모를 키우면서도 계산능력과 품질을 유지·향상시키는 능력 |
| State Space | 양자상태를 표현하는 공간으로 n큐비트의 차원은 2ⁿ |
| Physical Qubit | 실제 하드웨어에 구현된 개별 큐비트 |
| Logical Qubit | 오류정정 코드를 통해 여러 물리적 큐비트에 인코딩된 보호된 양자정보 |
| Connectivity | 어떤 물리적 큐비트들이 직접 상호작용할 수 있는지를 나타내는 구조 |
| Routing | 논리적 회로의 상호작용을 실제 하드웨어 연결구조에 맞게 변환하는 과정 |
| Quantum Error Correction | 여러 물리적 큐비트를 이용해 양자정보의 오류를 감지·수정하는 기술 |
| Fault Tolerance | 오류가 존재하는 상황에서도 오류 확산을 제어하며 신뢰성 있는 계산을 수행하는 구조 |
| Scale | 활용 가능한 양자계산 규모 |
| Quality | 오류가 계산을 지배하기 전까지 수행할 수 있는 신뢰성 있는 연산 능력 |
| Speed | 양자회로를 처리할 수 있는 실행속도와 처리량 |
양자컴퓨팅에서 큐비트 확장성이 중요한 가장 기본적인 이유는 큐비트 수가 증가할수록 표현할 수 있는 양자 상태공간이 2ⁿ차원으로 빠르게 커지기 때문입니다. 더 큰 문제와 복잡한 다중 큐비트 상태를 다루려면 충분한 큐비트가 필요합니다.
그러나 큐비트 수가 증가한다고 양자컴퓨터의 계산성능이 자동으로 좋아지는 것은 아닙니다. 많은 큐비트를 실제 계산에 이용하려면 높은 게이트 품질, 적절한 연결성, 빠른 실행과 정밀한 측정을 동시에 확보해야 합니다.
대규모 양자컴퓨팅에서는 오류정정도 중요한 문제입니다. 신뢰할 수 있는 하나의 논리 큐비트를 만들기 위해 여러 물리적 큐비트를 사용할 수 있기 때문에 실용적인 양자컴퓨터에는 알고리즘에서 보이는 논리 큐비트보다 훨씬 많은 물리적 자원이 필요할 수 있습니다.
또한 큐비트가 많아질수록 제어신호, 측정, 회로 배치와 라우팅, 오류 syndrome 처리 같은 주변 시스템도 함께 복잡해집니다. 확장성은 양자칩에 큐비트를 추가하는 문제만이 아니라 하드웨어와 소프트웨어 전체가 함께 커지는 문제입니다.
결국 좋은 양자컴퓨터의 확장성은 ‘얼마나 많은 큐비트를 만들었는가’보다 ‘늘어난 큐비트로 얼마나 크고 정확하며 빠른 계산을 지속할 수 있는가’로 이해하는 것이 좋습니다. 규모와 품질, 속도 그리고 오류정정이 함께 발전할 때 큐비트 수의 증가가 실제 계산능력의 증가로 이어질 수 있습니다.
참고문헌
큐비트 확장성과 양자 하드웨어 성능, 오류정정과 논리 큐비트에 관한 내용은 아래 공식 교육자료를 참고해 정리했습니다.
- IBM Quantum Learning, Quantum Computing Context – Scaling
- IBM Quantum Learning, Running Quantum Circuits
- IBM Quantum Learning, Foundations of Quantum Error Correction – Fault-Tolerant Quantum Computing
- IBM Quantum Learning, Controlling Error Propagation
- Microsoft Learn, Introduction to Quantum Error Correction
- Microsoft Learn, Hybrid Quantum Computing Concepts
- Microsoft Learn, Introduction to the Quantum Resource Estimator
- Microsoft Learn, Quantum Resource Estimator – Architecture and Error-Correction Parameters